שיווק לכמה מיקומים: איך מתחברים קישורי האתר והרשתות החברתיות
קישור משותף לרשת חברתית יכול להופיע לצד אפשרויות רבות לכתובת אתר. גם המצב ההפוך קיים. השוואה של 10 קובצי ייצוא של נתוני מיקום מראה מדוע בריף לקמפיין צריך לשמור על החיבור של כל רשומה לשני היעדים.
ניתוח של Influence IQ ל־10 קובצי ייצוא נבחרים של מפיקי נתונים ב־AllThePlaces, שנאספו ב־10–13 באוקטובר 2026. ההשוואה המבוססת על כתובות URL מכסה 3,843 רשומות עם קישורים גם לאתר וגם ל־Facebook; מזהי המקור הם מזהים בקובצי הייצוא, ולא מיקומים פיזיים שאומתו.
תקציר
בקמפיין לכמה מיקומים, שמרו על הקשר של כל רשומה גם לאתר שלה וגם לקישור שלה לרשת חברתית, גם אם קישור חוזר על עצמו. השווינו קישורים שסופקו לאותם מזהי מקור ב־10 קובצי ייצוא נבחרים של מפיקי נתונים ב־AllThePlaces, שנאספו ב־10–13 באוקטובר 2026. מתוך 3,843 רשומות עם כתובות URL גם לאתר וגם ל־Facebook, בקובץ הייצוא של Staples יש 1 כתובת URL של Facebook שמצורפת ל־1,758 כתובות URL שונות של אתרים. ב־Lush הכיוון הפוך: 13 כתובות URL של אתרים מופיעות לצד 408 כתובות URL שונות של Facebook. אצל 7 מפיקי נתונים יש דפוס של אחד־לאחד בכל הרשומות המצומדות שלהם. [1]
ההשוואה עוסקת במחרוזות שסופקו ובמזהים בקובצי הייצוא, ולא בדפים, בחשבונות או במיקומים פיזיים שאומתו. רק בשדה Facebook יש זוגות של כתובות URL בקבצים האלה; ערכי הטקסט המילוליים בשדות Instagram ו־Twitter מדווחים בנפרד. 10 קובצי הייצוא מכילים 15,797 רשומות שנכללו לאחר בדיקת מזהי המקור, ולכן זוגות לא שלמים נשארים גלויים בטבלת הכיסוי. המשמעות המעשית היא לשמר את הקשר בין האתר לרשת החברתית של כל מזהה ואת היקף הקמפיין המיועד כשמאשרים יעדים, גם אם קישור נשמר רק פעם אחת.
ליוצר התוכן יש את ההצעה המקומית, את הגרפיקה ואת רשימת הקישורים. לפני שאפשר לאשר פוסט, עדיין צריך לחבר את המיקום המיועד לרשומות הנכונות ברשימה. אם כמה רשומות חולקות קישור לרשת חברתית, האם פירוש הדבר שהן צריכות לחלוק גם יעד באתר?
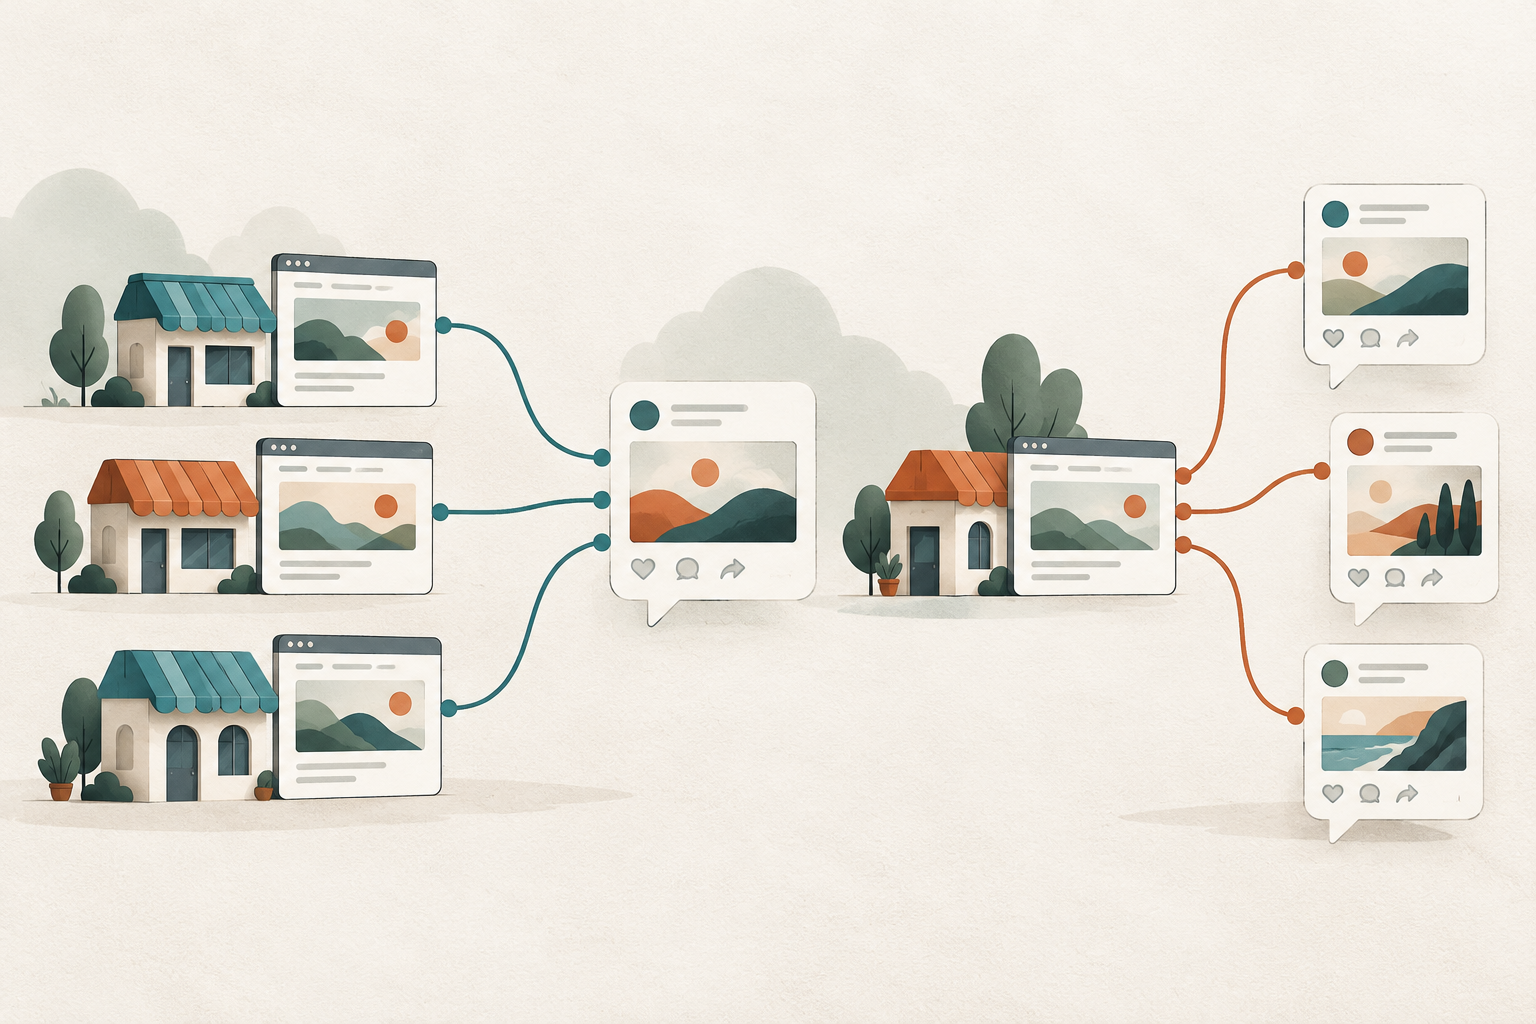
הקישורים שסופקו לא תמיד מתחלקים לאותן קבוצות. בקובצי הייצוא האלה, לחלק מהרשומות יש קישור נפרד בכל צד. אחרות חולקות קישור ל־Facebook אבל שומרות על כתובות אתר שונות, או חולקות אתר אבל שומרות על כתובות Facebook שונות. הצגת הקשרים האלה נותנת למי שמכין את הבריף אפשרות ברורה יותר לבחור.
הקשר יכול לפעול בשני הכיוונים
התחילו ברשומות שמכילות את שני הקישורים
ההשוואה מתחילה במזהה מקור: המזהה שמצורף לרשומה בקובץ ייצוא. אנחנו שומרים אותו יחד עם מפיק הנתונים שסיפק אותו. מפיק נתונים הוא כלי איסוף של AllThePlaces, ולא בהכרח 1 מותג. למשל, קובץ הייצוא של Bravo יכול לכלול כמה מותגים, ואילו הקובץ של OZK כולל רשומות של בנק וכספומטים. [1]
ב־10 קובצי הייצוא היו 3,843 רשומות שהכילו גם כתובת URL שמישה לאתר וגם כתובת URL שמישה ל־Facebook. השווינו את 2 השדות האלה באותן רשומות בנפרד לכל מפיק נתונים. השדות החברתיים האחרים הכילו מחרוזות מילוליות ולא כתובות URL, ולכן התוצאות שלהם מופיעות בנפרד בהמשך המאמר.
הטבלה מראה עד כמה הקשר הזה יכול להשתנות. ל־Arcaplanet יש 484 רשומות מצומדות, 484 כתובות URL שונות לאתר ו־484 כתובות URL שונות ל־Facebook. ל־AutoZone יש 692 מכל סוג. גם ל־Bravo, ל־J.Crew, ל־Madewell, ל־PetSuites ול־Coffee Bean יש כתובת אתר וכתובת Facebook נפרדות לכל רשומה בקבוצות המצומדות שלהם.
לכן אצל 7 מתוך 10 מפיקי הנתונים יש בהשוואה הזאת דפוס פשוט של אחד־לאחד. צוות ששומר על הזוגות המקוריים יכול להעביר את הקשר הזה לבריף בלי להמציא קיבוץ נוסף. המקרים האלה הם חלק מהממצא, לצד הדפוסים המרוכזים יותר ב־Staples, ב־Lush וב־OZK.
כאן, ״שונות״ פירושו מחרוזות URL שונות שסופקו, לפי כללי ההשוואה השמרניים שלנו. אנחנו משמרים נתיבים, שאילתות ומקטעים; איננו מבקרים ביעדים או מאחדים קישורים כי ייתכן שהם פותחים אותו דף. הספירות מתארות מלאי קישורים, ולא דפים או חשבונות נפרדים שאומתו. [2]
קישורי אתר ו־Facebook מתחלקים לקבוצות שונות ב־10 קובצי הייצוא
קובצי AllThePlaces שנאספו ב־10–13 באוקטובר 2026. כל שורה משתמשת רק ברשומות שמכילות גם כתובת URL לאתר וגם כתובת URL ל־Facebook; קישורים שונים הם מחרוזות URL שונות שסופקו, לפי כללי ההשוואה הקבועים.
| קובץ ייצוא של מפיק נתונים | רשומות עם שתי כתובות ה־URL | כתובות URL שונות לאתר | כתובות URL שונות ל־Facebook |
|---|---|---|---|
| Arcaplanet | 484 | 484 | 484 |
| AutoZone | 692 | 692 | 692 |
| Bravo | 7 | 7 | 7 |
| J.Crew | 69 | 69 | 69 |
| Lush | 408 | 13 | 408 |
| Madewell | 24 | 24 | 24 |
| OZK | 242 | 2 | 242 |
| PetSuites | 93 | 93 | 93 |
| Staples | 1,804 | 1,804 | 47 |
| The Coffee Bean & Tea Leaf | 20 | 20 | 20 |
השאירו רשומות לא שלמות בתמונה
3,843 הזוגות מגיעים מ־15,797 רשומות מקור שנכללו לאחר בדיקת המזהים. השוואה מצומדת עונה על שאלה לגבי רשומות עם שני השדות; היא אינה תיאור מלא של כל מה שסיפקו קובצי הייצוא. ב־10 הקבצים יש 9,174 רשומות עם כתובת אתר וללא כתובת Facebook, 8 עם Facebook ללא אתר, ו־2,772 ללא אף אחת מהן. [4]
הכיסוי משתנה במידה ניכרת. PetSuites מספקת את שתי כתובות ה־URL ב־93 מתוך 94 רשומות. AutoZone מספקת את שתיהן ב־692 מתוך 7,400, אף שלכל 7,400 הרשומות יש כתובת אתר. Staples מספקת את שתיהן ב־1,804 מתוך 5,425; ב־2,727 מהרשומות שלה אין אף אחד מ־2 השדות האלה. הצגת הסכום הכולל במקור לצד מספר הרשומות המצומדות מבליטה את ההבדלים האלה.
הספירות בהמשך הן של רשומות שמכילות כל שדה, ולכן עמודות האתר ו־Facebook חופפות. אלה אינן ספירות של יעדים שונים, ואין לחבר אותן כאילו היו קבוצות נפרדות. טבלת המיפוי הקודמת סופרת קישורים שונים רק בתוך הרשומות המצומדות שלה.
שדה חסר במקור הזה דורש בירור המשך, ואינו ראיה לכך שלעסק אין אתר או נוכחות ברשתות חברתיות. תהליך האיסוף יכול להשפיע על מה שנשאר בקובץ הייצוא. הקוד הנוכחי של AutoZone מסיר ערכים חברתיים מסוימים, והעשרה מאוחרת יותר יכולה להוסיף ערכים חסרים. הקוד הנוכחי עוזר להסביר מדוע צריך להיזהר בחוסרים במקור, אבל אי אפשר לקבוע איזו גרסת קוד הפיקה כל שדה היסטורי. [5]
בגיליון עבודה לקמפיין, שמרו רשומות לא שלמות בתור נפרד לבדיקה, עם מזהי המקור שלהן. ציינו איזה שדה צריך לבדוק ומי יטפל בו. כך זוג לא שלם לא ייעלם בשקט כשמכינים את הרשימה המצומצמת, וההחלטה על היעד שלו בהמשך תישאר לבדיקה עדכנית.
ההשוואה המצומדת מכסה חלק מכל קובץ ייצוא מקורי
רשומות ב־10 קובצי הייצוא הנבחרים של AllThePlaces שנאספו ב־10–13 באוקטובר 2026. כל ספירת שדה משתמשת בכל מזהי המקור שנכללו בניתוח של אותו מפיק נתונים, כולל רשומות שלא יכולות להיכלל בהשוואה המצומדת של אתר ו־Facebook.
| קובץ ייצוא של מפיק נתונים | כל רשומות המקור לאחר בדיקת המזהים | רשומות עם כתובת URL לאתר | רשומות עם כתובת URL ל־Facebook | רשומות עם שתי כתובות ה־URL |
|---|---|---|---|---|
| Arcaplanet | 626 | 626 | 484 | 484 |
| AutoZone | 7,400 | 7,400 | 692 | 692 |
| Bravo | 250 | 241 | 7 | 7 |
| J.Crew | 693 | 658 | 76 | 69 |
| Lush | 678 | 676 | 408 | 408 |
| Madewell | 162 | 159 | 25 | 24 |
| OZK | 275 | 274 | 242 | 242 |
| PetSuites | 94 | 94 | 93 | 93 |
| Staples | 5,425 | 2,698 | 1,804 | 1,804 |
| The Coffee Bean & Tea Leaf | 194 | 191 | 20 | 20 |
הפרידו בין ערך שסופק ונראה כמו שם משתמש לבין כתובת URL
את שדות Instagram ו־Twitter צריך לקרוא אחרת. ב־10 קובצי הייצוא האלה, הערכים השמישים והלא ריקים שלהם הם מחרוזות מילוליות ולא כתובות URL מלאות. חלקם נראים כמו שמות משתמש, אבל הניתוח לא מאמת אותם ולא בונה מהם קישורים. אנחנו משמרים את האיות, את האותיות הגדולות והקטנות ואת הסימן @ בתחילת הערך, אם ישנו, ומשווים את ערכי הטקסט האלה בנפרד. [6]
כאשר קיימת גם כתובת אתר, יש 3,711 רשומות עם ערך טקסט בשדה Instagram ו־3,501 עם ערך טקסט בשדה Twitter. הקבוצות האלה יכולות לכלול את אותם מזהי מקור, ולכן חיבור שלהן לא יספור מיקומים נפרדים. הטבלה שומרת כל שילוב של מפיק נתונים ופלטפורמה, גם כשיש 0 רשומות מצומדות.
גם תוצאות ערכי הטקסט מראות מדוע צריך לבדוק את הפורמט לפני מסירה. ל־Staples יש 2,697 זוגות עם ערך טקסט בשדה Instagram, עם 2,697 כתובות אתר ו־2 ערכים מילוליים שונים. ל־J.Crew יש 658 זוגות כאלה ב־Instagram, עם 655 כתובות אתר ו־3 ערכים. ל־PetSuites יש 86 זוגות עם 86 כתובות אתר ו־86 ערכים. הקשרים שסופקו שונים עוד לפני שבודקים לאן הערכים מובילים.
ערך טקסט יכול להיות חומר מקור מועיל בלי שיהיה מוכן להדבקה בשדה היעד של הקמפיין. שמרו את הערך המקורי, זהו את הפלטפורמה שלו ושמרו כל כתובת URL שאומתה בהמשך בשדה נפרד. תעדו מי אימת אותה ומתי. כך נשמרת ההבחנה בין מה שנכתב בקובץ הייצוא לבין מה שצוות הקמפיין אישר.
הטבלה הזאת בודקת את צורת הייצוג, ואינה דירוג של הפלטפורמות או ספירה של חשבונות מאומתים. תוצאות כתובות ה־URL וערכי הטקסט צריכות להישאר נפרדות בדוח, בדיוק כפי שצריך להבחין בין 2 הצורות בבריף העבודה.
ערכי הטקסט בשדות החברתיים נשארים חלק נפרד מהמלאי
כל 10 קובצי הייצוא הנבחרים של מפיקי נתונים ב־AllThePlaces, שנאספו ב־10–13 באוקטובר 2026. כל שורה מצמידה כתובת אתר לערך טקסט מילולי בשדה החברתי המצוין. בקבצים האלה לא היו זוגות של כתובות URL לשדות Instagram או Twitter.
הצגת כל 20 השורות של מפיקי הנתונים והפלטפורמות
| קובץ ייצוא של מפיק נתונים ושדה חברתי | רשומות עם כתובת אתר וערך טקסט | כתובות URL שונות לאתר | ערכי טקסט מילוליים שונים |
|---|---|---|---|
| Arcaplanet · שדה Twitter | 0 | 0 | 0 |
| Arcaplanet · שדה Instagram | 0 | 0 | 0 |
| AutoZone · שדה Twitter | 0 | 0 | 0 |
| AutoZone · שדה Instagram | 0 | 0 | 0 |
| Bravo · שדה Twitter | 1 | 1 | 1 |
| Bravo · שדה Instagram | 7 | 7 | 7 |
| J.Crew · שדה Twitter | 647 | 644 | 2 |
| J.Crew · שדה Instagram | 658 | 655 | 3 |
| Lush · שדה Twitter | 0 | 0 | 0 |
| Lush · שדה Instagram | 2 | 1 | 1 |
| Madewell · שדה Twitter | 153 | 153 | 1 |
| Madewell · שדה Instagram | 159 | 159 | 1 |
| OZK · שדה Twitter | 2 | 1 | 1 |
| OZK · שדה Instagram | 0 | 0 | 0 |
| PetSuites · שדה Twitter | 0 | 0 | 0 |
| PetSuites · שדה Instagram | 86 | 86 | 86 |
| Staples · שדה Twitter | 2,698 | 2,698 | 3 |
| Staples · שדה Instagram | 2,697 | 2,697 | 2 |
| The Coffee Bean & Tea Leaf · שדה Twitter | 0 | 0 | 0 |
| The Coffee Bean & Tea Leaf · שדה Instagram | 102 | 102 | 1 |
בנו את בריף האישור סביב הקהל המיועד
דמיינו יצירת תוכן למבצע סוף שבוע עבור 3 סניפים של קבוצת בתי קפה. הקמפיין מיועד ללקוחות ליד סניפי Riverside ו־Station; סניף Hill נמצא מחוץ לבריף. במלאי של מי שמתאם את הקמפיין יש קישור שונה לאתר לכל סניף, ואותו קישור חברתי שסופק בכל 3 השורות. זו דוגמה מומצאת, ולא קמפיין שנצפה במערך הנתונים.
קובץ שטוח עם 3 קישורי האתר ו־1 קישור חברתי משאיר ליוצר התוכן לברר איזה אתר שייך לאיזה סניף ואילו סניפים נכללים במבצע. בריף ששומר על המזהים יכול לשמור את היעד החברתי פעם אחת, לצרף את 3 מזהי הסניפים ולסמן את Riverside ו־Station כהיקף המיועד של הקמפיין.
מי שמתאם את הקמפיין יכול אז לבחור את היעד באתר לכל פוסט מאושר, או לבקש גרסאות מקומיות נפרדות. שימוש חוזר בקישור חברתי לא מכריע את הבחירה הזאת. הוא גם לא אומר שהקמפיין יכול להגיע רק לקהל המיועד; הגדרות ההפצה ותוכנית הפרסום בפועל דורשות אישור משלהן.
עכשיו דמיינו מלאי הפוך: לכל 3 מזהי הסניפים יש 1 קישור משותף לאתר, ואילו הקישורים החברתיים שלהם שונים. אישור האתר עדיין משאיר ליוצר התוכן כמה יעדים חברתיים. הבריף צריך לומר איזה מזהה ואיזה יעד חברתי שייכים לכל פוסט מתוכנן, במקום להסתמך על קיבוץ האתר כדי לספק את התשובה.
מלאו את השדות האלה מתוך המלאי של הצוות שלכם:
קמפיין והיקף מיועד: [קמפיין; מיקומים או קהלים שנכללים].
מקור ומזהים שנכללים: [מערכת; תאריך ייצוא; מפיק נתונים; מזהי רשומות].
קישורים לכל מזהה: [כתובת URL מלאה לאתר; פלטפורמה חברתית; כתובת URL חברתית מלאה או ערך טקסט שלא אומת].
צימוד מוצע ורשומות משויכות: [אילו מזהים משתמשים בכל שילוב של אתר ויעד חברתי].
בחירה מאושרת: [היעד שנבחר והסיבה; מי שבדק; תאריך הבדיקה].
פריטים פתוחים: [ערך חסר או לא ודאי; אחראי; הפעולה הבאה].
רשימת המזהים מאפשרת לבדוק את ההיקף; האישור מתעד את ההחלטה. אם יעד משתנה, הצוות יכול לראות אילו מזהים היו משויכים אליו ולבדוק מחדש את הרשומות האלה. אם אותו קישור משמש במכוון כמה רשומות, הוא יכול להישאר מקובץ בלי לאבד את רשימת הרשומות המשויכות. כך בריף קצר יכול לשמר את הקשרים בלי להפוך לעותק של כל קובץ הייצוא המקורי.
שמרו כל קשר בגיליון הקמפיין
שמרו את המזהה
שמרו את מזהה המקור ואת היקף הקמפיין המיועד בצמוד לרשומה.
חברו את שני היעדים
הראו איזה אתר ואיזה ערך חברתי שייכים לכל מזהה, כולל ערכים משותפים.
תעדו את הבחירה המאושרת
שמרו עם הבריף את האימות העדכני, את היעד שנבחר ואת הפריטים הפתוחים.
איך השווינו את הקישורים שסופקו
בחרנו 10 קובצי ייצוא מהרצת AllThePlaces שסומנה בתאריך 10 באוקטובר 2026; חותמות הזמן של איסוף הקבצים נפרשות על 10–13 באוקטובר. הבחירה התבססה על משפחה קבועה של מפיקי נתונים מבוססי Yext ועל כללים בקוד המקור, לפני שנבדקו תוצאות היעדים. זו השוואה מוגבלת של קובצי הייצוא האלה, ולא מדגם מייצג של עסקים. [1]
רשומה מזוהה לפי מפיק הנתונים ומזהה המקור שלה. קבענו איך לטפל במזהים חסרים, במזהים חוזרים ובערכי יעד סותרים לפני הניתוח. בקבצים בפועל, כל 15,797 פריטי הנתונים שויכו ל־15,797 מזהי מקור, ללא מזהים חסרים או לא תקינים, קבוצות מזהים סותרות או רשומות כפולות עודפות. לאחר מכן הוערכה בנפרד איכות שדות האתר והרשתות החברתיות.
לכתובות URL אנחנו דורשים תחביר שמיש של HTTP או HTTPS, ובשדות חברתיים גם שם מארח שמתאים לפלטפורמה. אנחנו ממירים לאותיות קטנות את סכמת הכתובת ושם המארח, ומשמרים נתיבים, מחרוזות שאילתה, מקטעים והבחנות אחרות. איננו עוקבים אחר הפניות ואיננו מניחים שכתיבים שונים מזהים חשבונות אמיתיים שונים. כל ערכי היעד שנצפו סווגו ככתובות URL, כערכי טקסט מילוליים או כחסרים; לא נותרו ערכי יעד שלא ניתן לסווג לפי הכללים הקבועים. [2]
כל מפיק נתונים וכל פלטפורמה נשארים בפלטים המלאים, גם בהקשרים עם 0 זוגות. הקיבוץ נעשה תמיד בנפרד לכל מפיק נתונים, וחזרה על ערך נבחנת באותה קבוצת רשומות מצומדות. 7 הטבלאות המצרפיות שומרות את ההתפלגויות המלאות של גודל הקבוצות בכל כיוון ואת פירוט החוסרים בזוגות. שחזור בלתי תלוי על סמך המקור התאים לכל 7 הטבלאות. הקובץ להורדה כולל את השיטה וקוד ניתוח נייד; את קובצי המקור עצמם מורידים בנפרד. [7]
קובץ ה-CSV של התרשימים כולל 170 ערכי ספירה, 1 לכל שורת נתונים, מתוך 50 שורות על פני 4 תרשימים. קובץ ה-ZIP שומר את כל 7 הטבלאות המצרפיות, כולל כיסוי מלא של צמדים והתפלגויות של גדלי קבוצות. הוא אינו כולל הפניות למקור ברמת הרשומה או מחרוזות יעד. כלולות הוראות מתורגמות; לשחזור נדרשת הורדה נפרדת של קובצי המקור הציבוריים.
מקורות והערות
- מקור: התורמים ל־AllThePlaces. ההרצה הקבועה מסומנת 2026-10-10-13-32-41; 10 הקבצים שנבחרו מדווחים על חותמות זמן של איסוף מ־10–13 באוקטובר 2026. הבחירה התבססה על קוד המקור הנוכחי המקובע של מפיקי הנתונים מבוססי Yext בגרסה e4264a6b9586fccd8815fe1796981e0ffce51e5f ועל מלאי מפיקי הנתונים המתוארך. היא אינה קובעת מה הייתה גרסת הקוד ההיסטורית לכל קובץ. שמות מפיקי הנתונים מזהים קובצי ייצוא; Bravo יכולה לכלול כמה מותגים, ו־OZK כוללת רשומות של בנק וכספומטים.
- ההשוואה ממירה לאותיות קטנות רק את סכמת ה־URL ושם המארח, אחרי הסרת הרווחים המותרים בשולי המחרוזת. היא משמרת הבדלי HTTP/HTTPS, את אופן הכתיבה של מספרי יציאות, נתיבים, מחרוזות שאילתה, מקטעים ותוחמים של שאילתות או מקטעים ריקים. כתובות חברתיות חייבות להשתמש בשם מארח מוצהר לשדה שלהן. לא בדקנו הפניות, תוכן דפים או זהות חשבונות. מחרוזות שונות שסופקו עדיין יכולות להתייחס לאותו יעד אמיתי.
- סך זוגות כתובות ה־URL של Facebook הוא 3,843. 4 מצבי החזרה הקבועים מכילים 0 רשומות שבהן שני הקישורים חוזרים, 1,758 שבהן רק Facebook חוזר, 649 שבהן רק האתר חוזר ו־1,436 שבהן אף קישור לא חוזר. חזרה מוגדרת בתוך הקבוצה המצומדת של כל מפיק נתונים. כל 1,758 הרשומות שבהן רק Facebook חוזר הן של Staples; 649 הרשומות שבהן רק האתר חוזר הן 408 של Lush ו־241 של OZK. ההתפלגויות המלאות של גודל הקבוצות נשמרות בחבילת המחקר.
- מתוך 15,797 מזהי מקור שנכללו לאחר בדיקת המזהים, הכיסוי של Facebook הוא: 3,843 עם כתובות URL גם לאתר וגם ל־Facebook; 9,174 עם אתר בלבד; 8 עם Facebook בלבד; ו־2,772 ללא אף אחת מהן. 8 הרשומות עם Facebook בלבד הן 7 של J.Crew ו־1 של Madewell. 4 תאי הכיסוי האלה מחלקים את מזהי המקור לקבוצות נפרדות; העמודות הנפרדות של נוכחות אתר ושל נוכחות Facebook חופפות.
- קוד המקור הנוכחי כולל שלבי הסרה והעשרה של שדות. AutoZone מסירה את Twitter דרך תהליך עיבוד משותף, ומסירה את Instagram ועוד 2 ערכי Facebook מדויקים בלוגיקה של מפיק הנתונים שלה; גם Coffee Bean מסירה את Twitter. שלב העשרה מאוחר יותר של Name Suggestion Index עשוי למלא שדות חסרים. המנגנונים הנוכחיים האלה אינם מוכיחים מה מקורו של ערך מסוים בקובץ ייצוא היסטורי, או מה גרם להיעדרו.
- ערך טקסט בשדה חברתי הוא מחרוזת שאינה URL ומתאימה לכלל התווים השמרני הקבוע. האיות, האותיות הגדולות והקטנות והסימן @ בתחילת הערך, אם קיים, נשמרים; לא משווים ערך כזה לכתובת URL ולא מאמתים אותו כחשבון. הקבוצות המצומדות לכתובות אתר מכילות 3,711 רשומות Instagram ו־3,501 רשומות Twitter. אותם מזהי מקור יכולים להיכלל בשתי הקבוצות. שורות עם 0 זוגות נשארות גלויות.
- AllThePlaces מעמיד את הנתונים שהוא יוצר לרשות הציבור במסגרת CC0. Influence IQ מפיק את ההשוואות המצרפיות ואת קוד הניתוח; התוצאות אינן מעידות על תמיכה מצד מיזם המקור או היוצרים ששמם מוזכר. חבילת המחקר כוללת את כל 7 הטבלאות המצרפיות והוראות שחזור מתורגמות. היא אינה כוללת הפניות ברמת הרשומה או מחרוזות יעד; שחזור הניתוח דורש את קובצי המקור הציבוריים שמורידים בנפרד.
המאמר באנגלית הוא מהדורת המקור. כל מהדורות השפה מתארות את אותם 10 קובצי ייצוא נבחרים של AllThePlaces שנאספו ב־10–13 באוקטובר 2026. התרגום לא הופך את הממצאים לאמת מידה לשוק המקומי או לעסקים כיום.