מסחור בחנות מקוונת: בדקו את ההנחות שלכם לגבי מיקום מוצרים
ניסוי היסטורי עם 10 ספרים מראה איך התאמה פשוטה למיקום יכולה להחמיץ חלקים מהדפוס, ואיך לבדוק את ההנחה הזאת לפני שמשווים כרטיסי מוצר.
ניתוח מחדש מקורי של ניסוי בחירת ספרים משנת 2024 שפרסמו Compiani, Morozov ו-Seiler.
תקציר
לפני שמחליטים שהצעה אחת חזקה מאחרת, עסק צריך להביא בחשבון היכן כל אחת הופיעה. השתמשנו בניסוי שפורסם משנת 2024 עם 10 ספרים אלקטרוניים כדי לבדוק 2 דרכים להביא בחשבון את המיקום. גישה שנותנת לכל מיקום התאמה משלו חזתה בחירות טוב יותר בסך הכול מהחלת אותה התאמה על כל ירידה של מקום ברשימה. בחלק מהמיקומים הבודדים היא הייתה פחות מדויקת, ולכן ההשוואה המלאה חשובה.
שני המודלים השתמשו באותו מידע על הספרים והמחירים. התאמנו אותם על 6,176 משתתפים ובדקנו את תחזיותיהם אצל 3,088 משתתפים אחרים. הבחירות היו היפותטיות, וכל אחד נדרש לבחור ספר. לעסקים וליוצרי תוכן שמשווים כרטיסי מוצר, הלקח הוא לבדוק הנחות על מיקום לפני שמייחסים תוצאות להצעה. המחקר אינו אומד עלייה במכירות ואינו מזהה את סדר המוצרים הטוב ביותר.
נניח שהמוצר בראש העמוד מקבל את מספר ההקלקות הגבוה ביותר. האם זו הצעה חזקה יותר, או שמקומו ברשימה עזר? עסק צריך תשובה מועילה לפני שהוא משכתב את הכרטיסים האחרים, מוזיל את הפריטים שנראים חלשים יותר או משנה את המבחר.
התחשבות במיקום נשמעת פשוטה עד ששואלים איך. האם כל ירידה של מקום ברשימה צריכה לקבל אותה התאמה? השתמשנו בניסוי היסטורי כדי להשוות בין הגישה הפשוטה הזאת לגישה גמישה יותר, ואז בדקנו את שתיהן על משתתפים שלא נכללו בהתאמת המודלים.
אותם מוצרים, מיקומים שונים
מה השוואה של מיקום מוצרים אמורה לומר לכם?
השוואת כרטיסי מוצר אמורה לעזור להפריד בין הפריט המוצע לאופן שבו הוצג. אם מוצר אחד מופיע בדרך כלל ראשון ואחר מופיע בדרך כלל אחרון, הסכומים שלהם לבדם אינם עונים על השאלה אם הקונים מעדיפים אחת מההצעות.
הגישה הפשוטה שאנו בודקים נותנת לכל ירידה של מקום ברשימה אותה התאמה לציון ההעדפה שבבסיס המודל. השאלה המועילה היא אם היא חוזה בחירות מספיק טוב בהשוואה למתן התאמות שונות למיקומים שונים.
בדקנו את 2 הגישות האלה באמצעות ניסוי בחירת ספרים שפורסם. התוצאה רלוונטית לעסקים וליוצרי תוכן שמשווים מוצרים בעמוד אוסף או בחלון ראווה דיגיטלי. היא מספקת דרך לבחון הנחת מדידה, ולא כלל למיקום הפריט הנמכר ביותר שלכם.
זה חשוב כשהצעה מופיעה ביותר ממקום אחד. יוצר יכול להציג את אותו תוכן להורדה באוסף ובעמוד השקה. קמעונאי יכול לשנות את סדר רשימת הקטגוריה. הפריט, המחיר, הקהל והתצוגה יכולים להשתנות יחד. התאמת מיקום היא הנחה לגבי חלק מההשוואה הזאת, והיא ראויה לבדיקה משלה.
מה אנשים בחרו בניסוי הספרים?
Giovanni Compiani, Ilya Morozov ו-Stephan Seiler ביקשו ממשתתפים שגויסו ב-Prolific לבצע בחירות היפותטיות מתוך 10 ספרים אלקטרוניים, בסדר ובמחירים שהוגרלו באקראי. המשתתפים נדרשו לבחור ספר; לא הייתה אפשרות לא לקנות דבר. אנו משתמשים במשימה הראשונה בכל הגשה שנשמרה, ולא במשימה המאוחרת יותר שבה הוסר הספר שנבחר.[1]
המחברים כבר מדווחים על תגובות למיקום ולמחיר. המחקר הרחב שלהם בוחן איך טקסט ותמונות עוזרים לאמוד תחליפיות בין מוצרים. השאלה שלנו ממוקדת יותר: האם החלפת איבר מיקום יחיד משפרת את החיזוי אצל משתתפים שבחירותיהם לא נכללו בהתאמת המודל?
יישום כללי ההכללה המקוריים משאיר 9,265 הגשות עם 9,264 מזהי משתתפים מובחנים ב-Prolific. מזהה 1 מופיע פעמיים. אנו משאירים את שתי ההגשות יחד ונותנים למשתתף הזה אותו משקל כולל כמו לכל משתתף אחר. הגשה אינה בהכרח אדם נפרד, ומשימה ראשונה אינה בהכרח החשיפה הראשונה של אותו אדם לניסוי.[2][3]
תאריכי המקור שנשמרו נעים בין 11 ביוני ל-26 ביוני 2024. כתב היד מתאר את 14–27 ביוני, ולכן אנו מציינים את ההבדל ואיננו מחריגים לפי תאריך. תנאי ההכללה לפי מדינה וגיל לא בוססו בחומרים שנבדקו; אלה אינם אומדנים לקונים בארה״ב או לאוכלוסייה לאומית אחרת.[1][2]
רשומות המשתתף נשמרות יחד לאורך כל ההשוואה
הגשות נבחרות של המשימה הראשונה לאחר כללי ההכללה המקוריים של המחברים; תאריכים ברשומות המקור שנשמרו: 11–26 ביוני 2024.
| קבוצה | משתתפים (לפי מזהה בפלטפורמה) | הגשות שנשמרו |
|---|---|---|
| כל מה שנשמר | 9,264 | 9,265 |
| אימון | 6,176 | 6,176 |
| נשמרו בצד להערכה | 3,088 | 3,089 |
איזה מודל מיקום חזה טוב יותר את הבחירות בקבוצת ההערכה?
מודל המיקום הגמיש חזה טוב יותר את הבחירות בקבוצת ההערכה לפי מדד הניקוד שהוגדר מראש. שני המודלים מביאים בחשבון איזה ספר הוצע ואת המחיר שהוצג. ההבדל היחיד ביניהם הוא אופן ייצוג המיקום.
מודל הבסיס משתמש במקדם 1 לכל ירידה של מקום ברשימה. המודל הגמיש משתמש בהתאמות נפרדות למיקומים 2 עד 10, ביחס למיקום הראשון. כך יש לו יותר חופש, אבל גם יותר פרמטרים לאמידה. התאמה טובה יותר לנתוני האימון שלו לא תכריע כשלעצמה בהשוואה.
לכן התאמנו את שני המודלים באמצעות 6,176 משתתפים והערכנו אותם על 3,088 המשתתפים האחרים. כל הגשה של משתתף נשארה באותו צד של החלוקה. קבוצת הבדיקה כוללת 3,089 הגשות משום שהיא כוללת את המשתתף החוזר.
כדי להשוות תחזיות, השתמשנו בציון לוגריתמי שלילי. מודל מקבל עונש קטן יותר כשהוא מייחס הסתברות גבוהה יותר לבחירה שאדם עושה בפועל. הוא מקבל עונש גדול יותר כשהוא מייחס לבחירה הזאת הסתברות נמוכה מאוד. ממוצע נמוך יותר של ציונים לוגריתמיים שליליים הוא טוב יותר.
הממוצע בקבוצת ההערכה היה 2.2260 למודל הבסיס ו-2.2154 למודל הגמיש, ביחידות לוגריתם טבעי שנקראות גם nats. אלה ציוני חיזוי, ולא אחוזי תשובות נכונות. ציוני האימון והבדיקה מוצגים יחד כדי שההשוואה לא תישען על המשימה הקלה יותר של תיאור נתונים שהמודל כבר ראה.
2 מודלים שנבדקו על אותם משתתפים
בחירות נבחרות במשימה הראשונה עם 10 ספרים משנת 2024. אימון: 6,176 משתתפים והגשות. בדיקה: 3,088 משתתפים ו-3,089 הגשות.
| מודל מיקום | ציון אימון (nats) | ציון בקבוצת ההערכה (nats) |
|---|---|---|
| איבר מיקום לינארי 1 | 2.2046 | 2.2260 |
| איברי מיקום נפרדים | 2.1899 | 2.2154 |
השיפור המזווג היה 0.0106 nats למשתתף, עם רווח מקורב של 95% בין 0.0044 ל-0.0168. כאן שיפור חיובי הוא לטובת המודל הגמיש. התוצאה קטנה בסולם הניקוד הזה, אבל הרווח נמצא מעל 0.[4]
הרווח הזה מתייחס ל-2 המודלים המותאמים כקבועים ומניח קבוצות משתתפים בלתי תלויות. הוא אינו כולל אי-ודאות מהתאמת המודלים על מדגם אימון אחר. הממצא תומך בשיפור חיזוי במשימה ההיסטורית הנבחרת הזאת; הוא אינו הופך את הפרש הציונים לעלייה במכירות.
המודל הגמיש משפר את הציון הלוגריתמי בקבוצת ההערכה
השוואה מזווגת בין 3,088 משתתפי בדיקה במשימה ההיסטורית הנבחרת של 10 ספרים.
| השוואה | שיפור (nats) | רווח של 95%: גבול תחתון (nats) | רווח של 95%: גבול עליון (nats) |
|---|---|---|---|
| הציון הלוגריתמי של המודל הגמיש פחות הציון של מודל הבסיס | 0.0106 | 0.0044 | 0.0168 |
היכן 2 המודלים החמיצו את הבחירות שנצפו?
השוואת המיקומים המלאה מראה למה הציון הכולל צריך לבוא עם פירוט. בכל מיקום, אנו משווים את שיעור הבחירה שנצפה להסתברות הממוצעת שכל מודל ייחס לו. אלה ממוצעים עם משקל שווה לכל משתתף בקבוצת ההערכה, ולא שיעורי הקלקה.
במיקום 1, השיעור שנצפה היה 17.16%. מודל הבסיס חזה 14.64%, בעוד שהמודל הגמיש חזה 17.73%. במיקום 10, השיעור שנצפה היה 9.18%, לעומת תחזיות של 6.37% ו-8.74%. המודל הגמיש היה קרוב יותר בשני הקצוות של הרשימה המסוימת הזאת.
בחירות שנצפו ונחזו בכל 10 המיקומים
קבוצת הערכה: 3,088 משתתפים ו-3,089 הגשות של המשימה הראשונה מהניסוי שפורסם משנת 2024.
| מיקום | שיעור הבחירה שנצפה | ההסתברות הממוצעת של מודל הבסיס | ההסתברות הממוצעת של המודל הגמיש | הגשות שבהן המיקום נבחר |
|---|---|---|---|---|
| מיקום 1 | 17.16% | 14.64% | 17.73% | 530 |
| מיקום 2 | 13.60% | 13.20% | 14.84% | 420 |
| מיקום 3 | 9.91% | 12.06% | 9.74% | 306 |
| מיקום 4 | 10.91% | 11.21% | 9.26% | 337 |
| מיקום 5 | 9.20% | 10.09% | 8.94% | 284 |
| מיקום 6 | 7.08% | 9.25% | 8.01% | 219 |
| מיקום 7 | 8.00% | 8.44% | 7.57% | 247 |
| מיקום 8 | 7.12% | 7.67% | 7.47% | 220 |
| מיקום 9 | 7.84% | 7.08% | 7.69% | 242 |
| מיקום 10 | 9.18% | 6.37% | 8.74% | 284 |
המודל הגמיש לא היה קרוב יותר בכל מקום. במיקום 4, השיעור שנצפה היה 10.91%. מודל הבסיס חזה 11.21%, בעוד שהמודל הגמיש חזה 9.26%. הגמישות הנוספת שיפרה את הציון הכולל בקבוצת ההערכה, אבל הותירה פער גדול יותר במיקום הזה.
הטבלה הבאה מציגה שיעורים שנצפו פחות שיעורים שנחזו. פער חיובי פירושו שהמודל חזה מעט מדי בחירות במיקום הזה; פער שלילי פירושו שחזה יותר מדי. השארת כל 10 המיקומים גלויים מונעת מקצה שנראה טוב לייצג את ההשוואה כולה.
הפערים של שני המודלים מהבחירות שנצפו
שיעור הבחירה שנצפה פחות ההסתברות החזויה הממוצעת בכל אחד מ-10 המיקומים, באמצעות אותם 3,088 משתתפי בדיקה.
| מיקום | השיעור שנצפה פחות תחזית מודל הבסיס | השיעור שנצפה פחות תחזית המודל הגמיש |
|---|---|---|
| מיקום 1 | 2.52 נקודות אחוז | -0.57 נקודות אחוז |
| מיקום 2 | 0.41 נקודות אחוז | -1.24 נקודות אחוז |
| מיקום 3 | -2.15 נקודות אחוז | 0.17 נקודות אחוז |
| מיקום 4 | -0.29 נקודות אחוז | 1.65 נקודות אחוז |
| מיקום 5 | -0.89 נקודות אחוז | 0.26 נקודות אחוז |
| מיקום 6 | -2.17 נקודות אחוז | -0.93 נקודות אחוז |
| מיקום 7 | -0.44 נקודות אחוז | 0.43 נקודות אחוז |
| מיקום 8 | -0.55 נקודות אחוז | -0.35 נקודות אחוז |
| מיקום 9 | 0.76 נקודות אחוז | 0.14 נקודות אחוז |
| מיקום 10 | 2.81 נקודות אחוז | 0.44 נקודות אחוז |
שורות המיקום האלה תיאוריות, ללא טענות מובהקות נפרדות. הניסוי לא מדד תנועות עיניים או תשומת לב, והניתוח הזה אינו מזהה למה מיקום שונה. גם דפוס מעוקל של שיעורים שנצפו אינו מפריך כשלעצמו את מודל הבסיס: איבר המיקום שלו לינארי בציון ההעדפה שבבסיס המודל, ולא באחוזי הבחירה.
חיסור פשוט של השיעורים שנצפו במקום הראשון והאחרון יענה על שאלה אחרת. השיעורים האלה מסכמים בחירות על פני מוצרים ומחירים. שני המודלים המותאמים מביאים בחשבון את זהות הספר ואת המחיר לפני שהם מייחסים הסתברויות ל-10 האפשרויות. לא הפרש הקצוות ולא השוואת המודלים אומרים מה יקרה אם תזיזו מוצר מסוים בחנות פעילה.
תבנית מדידה של מיקום מוצרים שאפשר להשתמש בה
לפני שמשווים הצעות, כתבו בריף מדידה קצר. התבנית הבאה זמינה ללא הרשמה ומיועדת להמחשה. היא מיישמת את לקח המחקר על בדיקת הנחות; היא אינה מבטיחה שאותו מודל יתאים לחנות שלכם.
החלטה: ״עלינו להחליט [איזו השוואת מוצרים או שינוי בתצוגה] עבור [עמוד או קמפיין] במהלך [תקופה]״. הגדירו את ההחלטה לפני שבוחרים מדד מחמיא.
תוצאה: ״נמדוד [בחירה, הקלקה, הוספה לעגלה או רכישה]״. בחרו את התוצאה שהרשומות שלכם תומכות בה בפועל. שמרו לצדה את החלופות שהוצעו, את סדרן ואת המחירים שהוצגו. תוצאה של בחירה כפויה צריכה להישאר נפרדת מתוצאת רכישה.
יחידה: ״היחידה שלנו היא [משתתף או יחידה מוגדרת בבירור אחרת]. ביקורים או הגשות חוזרים יטופלו לפי [כלל]״. שמרו יחד את התצפיות של אותו אדם כשמעריכים חיזוי לאנשים חדשים. אל תתייחסו למזהה סשן אנונימי כהוכחה לאדם ייחודי.
השוואה: ״שני המודלים ישתמשו באותם מוצרים, מידע מחירים ותצפיות שעומדות בתנאי ההכללה. הם יהיו שונים ב[הנחת המיקום]״. פרטו גם את החלופה הפשוטה וגם את הגמישה יותר.
הערכה: ״נשמור בצד [קבוצה מוגדרת] לפני ההתאמה ונשווה [מדד ניקוד מוגדר]. נציג את כל המיקומים״. החליטו איך לדווח על תוצאה שלא הוכרעה או על תוצאה גרועה יותר לפני שרואים אותה.
שימוש: ״התוצאה הזאת תסייע ל[החלטת מדידה]. עדיין דרושות ראיות לגבי [תוצאה מסחרית שלא נמדדה כאן] לפני [החלטה מסחרית]״. המשפט האחרון מונע מתרגיל חיזוי להפוך בשקט לתחזית הכנסות.
שמרו את אותו משתתף בצד אחד של הבדיקה
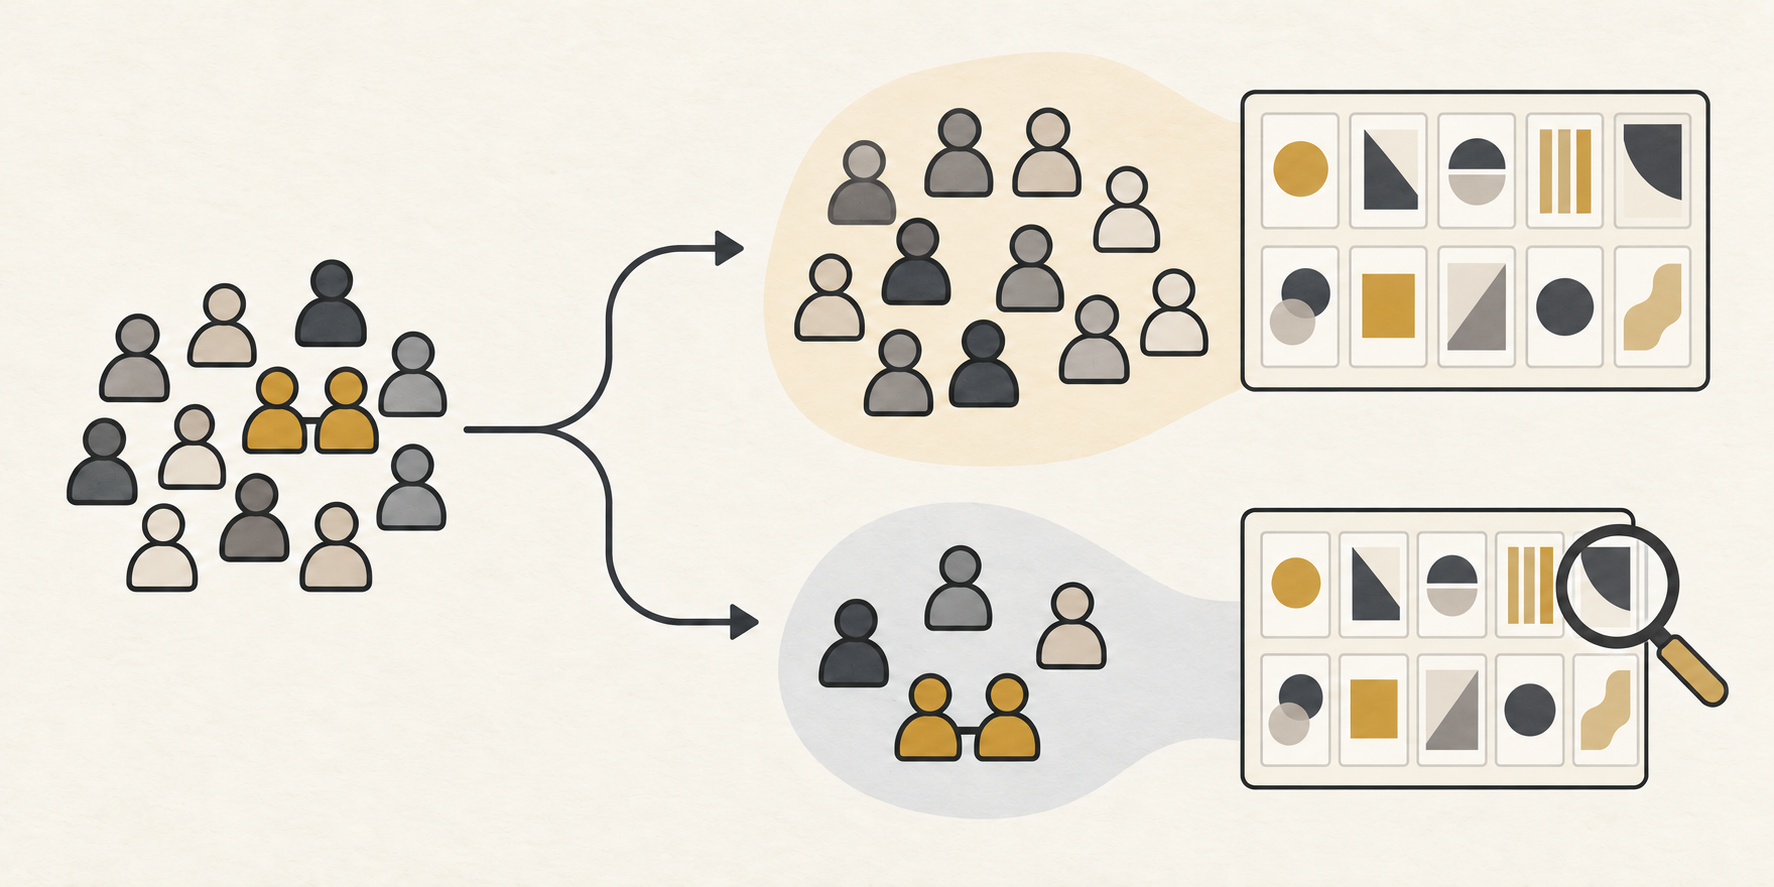
הגדירו את ההשוואה
ציינו את המוצר, המיקום, התוצאה ויחידת התצפית.
שמרו את קבוצת ההערכה בצד
שמרו יחד את ההגשות של כל משתתף.
בדקו את התוצאה המלאה
השוו תחזיות והציגו כל מיקום, לרבות תוצאות גרועות יותר.
דוגמה מפורטת: יוצר תוכן שמשווה הצעות דיגיטליות
חשבו על יוצר בדיוני שמוכר חוברת עבודה לכתיבה, סדנה וחבילה. החבילה מופיעה בראש עמוד ההשקה ומקבלת את מספר ההקלקות הגבוה ביותר. היוצר שוקל לשכתב את תיאורי המוצרים האחרים.
בריף המדידה משנה את השאלה המיידית. התוצאה שנצפתה היא הקלקה, ולא מכירה. הרשומות הזמינות צריכות להראות אילו הצעות הוצגו, באיזה סדר ובאילו מחירים. אם החבילה תמיד נמצאת במקום הראשון, הרשומות האלה אינן יכולות להפריד בבירור בין החבילה הזאת למיקום הזה.
הבריף הממולא של היוצר יכול לומר: ״אנו רוצים לדעת אם הדרך שלנו להביא בחשבון מיקום חוזה הקלקות של מבקרים חדשים. נשווה את אותן הצעות ואותו מידע מחירים, נשמור תצפיות חוזרות יחד ונדווח על השוואת המיקומים המלאה. לא נטען דבר על רכישות על סמך רשומות הקלקה״. זו דוגמה בדיונית לשאלת מדידה, ולא תוצאה מוצעת.
צעד הבא סביר הוא לתכנן השוואה עם מספיק שונות כדי להבחין בין מוצר למיקום, תוך שמירה על אותה הגדרת תוצאה. לאחר מכן היוצר יוכל להשוות התאמת מיקום פשוטה לגישה גמישה יותר בקבוצה שנשמרה בצד. זה יהיה מחקר חדש על העמוד הזה; ניסוי הספרים אינו מספק שיעור הקלקה צפוי עבורו.
אם הגישה הגמישה חוזה טוב יותר את ההקלקות בקבוצה שנשמרה בצד, ליוצר יש סיבה לבחון מחדש איך הדוח מביא בחשבון מיקום. זה עדיין אינו מראה שהזזת החבילה תגדיל הכנסות. החלטה מסחרית תדרוש ראיות על שינוי התצוגה בפועל ועל התוצאה שחשובה לעסק.
אם ההשוואה לא הוכרעה, היוצר צריך לומר זאת. גמישות נוספת אינה בהכרח כלי עסקי טוב יותר. התועלת המעשית היא רצף ברור יותר: להבין מה הרשומות יכולות להפריד, לבדוק את הנחת המדידה ואז להחליט אם דרוש ניסוי נוסף.
איך Influence IQ חישב את ההשוואה?
השתמשנו במהדורת התשובות הערוכה של המחברים ובכללי הבחירה המקוריים. 553 רשומות הפיילוט או הבדיקה הראשונות מוחרגות לפי מיקומן הקבוע בקובץ. המסגרת שנותרה כוללת 10,775 הגשות. מסנני ההבנה משאירים 9,344; מסנן ההשלמה משאיר 9,265.[2]
הסכמה, מצב השלמה וכלל משך הזמן המזערי של 60 שניות אינם מסירים הגשות נוספות בשלבים שלהם. השלמה ומשך זמן הם מסננים שאחרי החשיפה, ולכן הקבוצה שנשמרה היא מדגם נבחר.
מזהי המשתתפים של Prolific מגדירים את הקבוצות. חלוקה דטרמיניסטית לפי גיבוב מקצה שני שלישים מהקבוצות לאימון ואת השאר לבדיקה, ללא שימוש בבחירותיהם. בתוך כל קבוצה, כל הגשת משימה ראשונה שנשמרה חולקת באופן שווה את תרומת המשתתף. אותו שקלול חל על התאמה, ניקוד וטבלאות המיקום.[3]
שני המודלים הם מודלי לוגיט רב-קטגוריים ללא ענישה, עם 9 משתני חיווי לספרים ואיבר מחיר לינארי 1. מודל הבסיס מוסיף איבר מיקום לינארי 1, ובסך הכול 11 פרמטרים. המודל הגמיש מוסיף 9 משתני חיווי למיקום, ובסך הכול 19. מיקום 1 ומזהה המוצר הקטן ביותר מספרית הם קטגוריות הייחוס. כל קבוצות הבחירה שעומדות בתנאי ההכללה מכילות את אותם 10 מוצרים, ונבדקה התאמה בין המזהה שנבחר, המחיר והמיקום.
אנו מתאימים את המודלים על קבוצת האימון, שומרים את המקדמים שנאמדו ואז נותנים ציון לבחירות הבדיקה. הרווח משתמש בסטיית התקן של הפרשי הציונים המזווגים לכל משתתף, ב-3,088 יחידות משתתף וב-3,087 דרגות חופש. זהו רווח Student-t מקורב, למעט כשהנחותיו המדויקות לגבי ציונים נורמליים מתקיימות. כל 10 השוואות המיקום נשארות תיאוריות.[4]
מנגנון האופטימיזציה הראשי של מודל הבסיס החזיר אזהרה מספרית. הוא עדיין עמד בכל תנאי הדיוק שהוגדרו לפני ההתאמה, לרבות השוואה מנקודת התחלה שנייה. שמרנו את ההתאמה המקורית הזאת; האבחונים המפורטים כלולים בחומרי השחזור.[5]
ההורדות מספקות את התוצאות המוצגות, קוד ניתוח מקורי ופלט מספרי מצטבר. הן אינן כוללות שורות תשובות מקור, מזהי משתתפים או איורי ספרים. השיגו את נתוני המקור בנפרד מהמהדורה שפרסמו המחברים. Influence IQ אחראי לניתוח מחדש ולפרשנותו.
קובץ ה-CSV משתמש בשפת העמוד הזה. החבילה מכילה קוד חישוב מקורי, תיעוד שיטה מתורגם ותוצאות מצטברות. שורות תשובות המקור ונכסי הספרים אינם כלולים; השיגו את הנתונים בנפרד מהמהדורה שפרסמו המחברים.
מקורות והערות
- Compiani, Morozov ו-Seiler, Demand Estimation with Text and Image Data, גרסת כתב יד 4, 17 בפברואר 2026, סעיף 3 ונספח C. המחברים כבר חוקרים תגובות למיקום ולמחיר. השוואת המשתתפים בקבוצת ההערכה שלנו היא ניתוח מחדש מקורי וממוקד יותר.
- מהדורת DeepLogitReplication של המחברים בגרסה 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. אנו פועלים לפי סף הפיילוט המקורי לפי מיקום בקובץ התשובות הערוך וכללי ההכללה של המחברים. תאריכי המקור שנשמרו הם 11–26 ביוני 2024, בניגוד לתיאור 14–27 ביוני בכתב היד; התאריכים אינם קובעים הכללה.
- Prolific מבחינה בין מזהה משתתף למזהה מחקר או הגשה. אנו שומרים את מזהי המשתתפים המדויקים לצורך קיבוץ. המזהים האלה אינם מאמתים באופן עצמאי שכל מזהה מייצג אדם אחר ואינם מבססים שהגשה שנשמרה הייתה החשיפה הראשונה של אותו אדם.
- ההשוואה שהוגדרה מראש ב-Influence IQ מחשבת את ממוצע ההפרש בין לוג ההסתברות במודל הגמיש לזה שבמודל הבסיס, תחילה בתוך כל משתתף בדיקה ואז על פני המשתתפים. הרווח של 95% הוא הממוצע בתוספת או בהפחתת הערך הקריטי של Student-t כפול סטיית התקן של הפרשי הציונים ברמת המשתתף חלקי השורש הריבועי של 3,088. הוא מניח קבוצות משתתפים בלתי תלויות, מותנה בהתאמות אימון קבועות ואינו כולל אי-ודאות בהתאמת האימון; דיוק מלא דורש הפרשי ציונים ברמת המשתתף בעלי התפלגות נורמלית זהה ושונות משותפת.
- התאמת מודל הבסיס מנקודת התחלה אפס החזירה אזהרת דיוק. הגרדיאנט הממוצע המרבי בערך מוחלט שלה היה 3.12×10⁻⁹, ירידת ניוטון 2.50×10⁻⁸ והפרש ההסתברות הלוגריתמית המרבי בין 2 נקודות התחלה היה 7.46×10⁻⁸, מתחת לספים שהוגדרו מראש: 10⁻⁸, 10⁻⁶ ו-10⁻⁷. שני המודלים עמדו גם בתנאי העקמומיות החיובית והתאמת ערכי פונקציית המטרה. המקדמים הראשיים מנקודת התחלה אפס נשמרו.
המאמר באנגלית הוא גרסת המקור. גרסאות השפה מתארות את אותו ניסוי היסטורי; הן אינן אומדני קניות לפי מדינה.