Hvilke opskriftskommentarer bør du læse for at få feedback?
At læse kommentarerne med flest positive stemmer eller de nyeste kommentarer kan ændre den fordeling af bedømmelser, du ser. En sammenligning af udvalg på 10 kommentarer på tværs af 100 udvalgte opskriftsdiskussioner viser, hvorfor læsemetoden bør følge det spørgsmål, du vil besvare.
En analyse af 18.182 kommentarer i et opskriftsarkiv udgivet af UCI i 2023.
Resumé
Når målet var at afspejle bedømmelsesfordelingen i en opskriftsdiskussion, kom tilfældig udvælgelse i gennemsnit tættere på end valg af kommentarerne med flest positive stemmer eller de nyeste kommentarer. Influence IQ sammenlignede udvalg på 10 kommentarer på tværs af et udvalg af 100 højt bedømte opskrifter i et historisk arkiv med 18.182 kommentarer udgivet af UCI i 2023. De gennemsnitlige forventede afvigelser i bedømmelsesfordelingen var 16,5 procentpoint for tilfældig udvælgelse, 18,7 for positive stemmer og 20,3 for de nyeste kommentarer. [1][4]
Resultatet måler fordelingen af kommentarer bedømt med 1–5 stjerner og kommentarer uden bedømmelse, ikke hvor nyttige deres råd er. Udvælgelse efter positive stemmer kom tættere på end tilfældig udvælgelse for 46 opskrifter og længere væk for 54. For indholdsskabere, der arbejder med mad, og communityansvarlige er konsekvensen at skelne mellem et udvalg, der bruges til at opsummere en diskussion, og eksempler, der bruges til at planlægge et svar.
Du har en opskrift, der skal forbedres, og en lang diskussion under den. Der er tid til at læse et lille udvalg af kommentarer, før du beslutter, hvad du vil afklare. Begynder du med kommentarerne, der har fået flest stemmer, de nyeste bidrag eller et tilfældigt udvalg fra diskussionen?
Valget sker, før du fortolker en eneste sætning. Det bestemmer, hvilke stemmer der indgår i den brief, du giver til en indholdsskaber, redaktør eller kollega. Vi undersøgte, hvordan 3 udtrykkelige udvælgelsesregler ændrede 1 målbar egenskab ved briefen: balancen mellem bedømmelser, inklusive kommentarer, hvis forfattere ikke gav nogen bedømmelse.
Et udvalgt indblik i en større diskussion
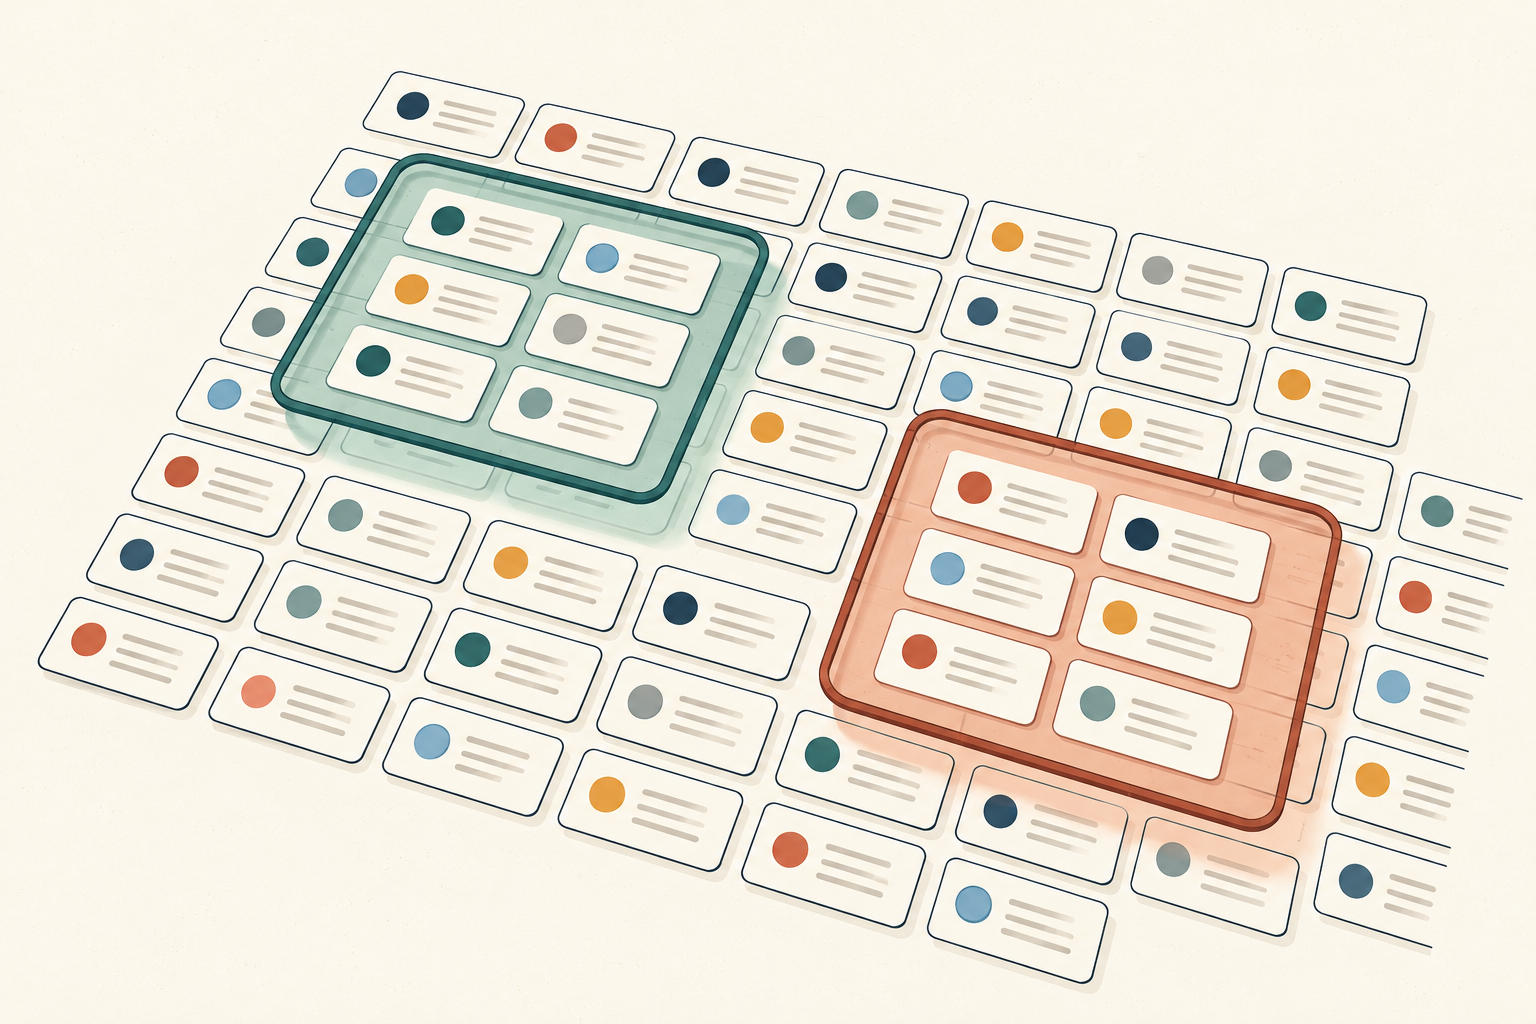
- Udvalgte kommentarer
- Hele den arkiverede diskussion
10 kommentarer kan give 3 forskellige indblik
En indholdsskaber, der forbereder en opfølgning på en opskrift, skal beslutte, hvad der skal læses først. Kommentarerne med flest positive stemmer kan ligne en nyttig genvej. De nyeste kommentarer giver en anden indgang til diskussionen. Begge sætter nogle kommentarer foran andre, men ingen af udvalgene beskriver automatisk hele diskussionen.
Vi testede det snævre spørgsmål med 18.182 arkiverede kommentarer til 100 udvalgte, højt bedømte Taste of Home-opskrifter i et offentligt datasæt udgivet gennem UCI i 2023. For hver opskrift sammenlignede vi 10 kommentarer valgt efter positive stemmer, 10 valgt efter oprettelsestidspunkt og 10 valgt tilfældigt. Referencen var bedømmelsesfordelingen blandt alle arkiverede kommentarer til den opskrift. [1]
Den gennemsnitlige forventede afvigelse fra den fulde bedømmelsesfordeling var 18,7 procentpoint for udvalg efter positive stemmer, 20,3 for de nyeste kommentarer og 16,5 for tilfældig udvælgelse. Hver opskrift bidrog lige meget til gennemsnittene, uanset hvor mange kommentarer den havde. [4]
Sammenlignet med tilfældig udvælgelse var afvigelsen 2,2 procentpoint større for positive stemmer og 3,8 procentpoint større for de nyeste kommentarer. Forskellene vedrører fordelingen af bedømmelser og kommentarer uden bedømmelse. Vi målte ikke, hvilke kommentarer der gav de bedste madlavningsråd, den klareste forklaring eller den nyttigste forretningsidé.
Den skelnen er vigtig for en indholdsskaber, der arbejder med mad, eller en communityansvarlig. En kommentar kan være værdifuld nok til at inspirere en vejledning uden at være typisk for diskussionen. At behandle den som et eksempel er en anden beslutning end at behandle et kort udvalg som en opsummering.
Gennemsnitlig afvigelse fra hver opskrifts fulde bedømmelsesfordeling
10 kommentarer pr. udvalg på tværs af 100 udvalgte opskriftsdiskussioner i det historiske UCI-arkiv. En mindre afvigelse betyder et tættere match i fordelingen af bedømmelser og kommentarer uden bedømmelse.
| Udvælgelsesmetode | Gennemsnitlig forventet afvigelse |
|---|---|
| Flest positive stemmer | 18,7 procentpoint |
| Nyeste efter oprettelsestidspunkt | 20,3 procentpoint |
| Tilfældig udvælgelse | 16,5 procentpoint |
Hvad betyder en afvigelse i bedømmelsesfordelingen?
Tænk på hver opskriftsdiskussion som en blanding af 6 kategorier: 1 til 5 stjerner samt kommentarer uden bedømmelse. Et udvalg på 10 kommentarer har sin egen blanding. Vi målte, hvor langt den mindre blanding lå fra hele den arkiverede diskussion, med et mål kaldet totalvariationsafstand.
Her er et hypotetisk eksempel med kun 2 kategorier. Antag, at halvdelen af kommentarerne giver 4 stjerner og halvdelen 5 stjerner. Hvis et udvalg på 10 kommentarer indeholder 7 kommentarer med 4 stjerner og 3 med 5 stjerner, er fordelingen 70 % mod 30 % frem for 50 % mod 50 %. Afstanden er 20 procentpoint: halvdelen af de 2 absolutte forskelle på 20 procentpoint.
Samme beregning virker på tværs af alle 6 kategorier. En mindre værdi betyder et tættere match med arkivets bedømmelsessammensætning. Det betyder ikke, at teksten er mere informativ, eller at kommentarerne er mere sandfærdige. Et resultat på 18,7 procentpoint betyder heller ikke, at 18,7 % af kommentarerne er forkerte.
Vi beholdt kommentarer uden bedømmelse i sammenligningen. UCI definerer 0 i bedømmelsesfeltet som ingen bedømmelse, ikke en score under 1 stjerne. Hvis de kommentarer blev fjernet, ville det ændre den diskussion, der opsummeres. Talkategorien alene kan ikke fortælle, om en kommentar uden bedømmelse indeholder et spørgsmål, ros, et problem eller noget andet. [1]
Tilfældig udvælgelse kom i gennemsnit tættere på, men ikke for hver opskrift
Den samlede sammenligning giver ikke en universel vinder. Udvælgelse efter positive stemmer havde en mindre forventet afvigelse end tilfældig udvælgelse for 46 af de 100 opskrifter og en større afvigelse for 54. Udvælgelse af de nyeste kommentarer kom tættere på for 42 opskrifter og længere væk for 58. Ingen af sammenligningerne havde en præcis lighed. [4]
Det er sammenligninger mellem hver metodes forventede afvigelse inden for en opskrift. De betyder ikke, at alle mulige tilfældige udtræk er bedre end udvælgelse efter positive stemmer i de 54 diskussioner. Et bestemt udtræk på 10 kommentarer kan tilfældigvis ligne hele diskussionen tæt eller gå glip af dele af den.
Det tilfældige resultat er et gennemsnit over alle mulige udvalg på 10 kommentarer med samme sandsynlighed for hvert udvalg. Det er ikke resultatet af 1 heldigt udtræk eller et valgt tilfældighedsseed. Vi tog også gennemsnittet over alle mulige udvalg ved lighed, når flere kommentarer havde samme antal positive stemmer eller samme tidsstempel ved udvælgelsesgrænsen.
Lighed ved udvælgelsesgrænsen krævede gennemsnitsberegning for 70 opskrifter ved udvælgelse efter positive stemmer og 4 ved udvælgelse af de nyeste kommentarer. Vi foretrak ikke én kommentar i ligheden på grund af dens forfatter, rækkeplacering eller identifikator. Beregningen spørger, hvad der sker med en angivet udvælgelsesregel, frem for at behandle en vilkårlig rækkefølge som belæg. [4]
For en indholdsskaber er den praktiske konsekvens beskeden, men nyttig: Positive stemmer og kommentarernes alder er udvælgelseskriterier. Hvis du bruger et af dem til at opsummere en diskussion, skal du angive valget. Antag ikke, at et synligt kort udvalg bevarer balancen i hele arkivet.
Den metode, der kom tættest på, varierede mellem opskriftsdiskussionerne
Hvert rangordnet udvalg sammenlignes med tilfældig udvælgelse inden for samme opskrift. Det er sammenligninger af forventede afvigelser, ikke udfald fra enkelte tilfældige udtræk.
| Udvælgelsesmetode | Tættere på end tilfældig udvælgelse | Samme afvigelse som ved tilfældig udvælgelse | Længere væk end tilfældig udvælgelse |
|---|---|---|---|
| Flest positive stemmer kontra tilfældig udvælgelse | 46 | 0 | 54 |
| Nyeste kommentarer kontra tilfældig udvælgelse | 42 | 0 | 58 |
Vælg spørgsmålet, før du vælger kommentarerne
Metoder til kundefeedback tjener forskellige formål. En virksomhed kan ville forstå et bredt mønster, undersøge et bestemt problem eller finde et spørgsmål til sit næste opslag. Denne undersøgelse handler om 1 del af arbejdet: om et lille udvalg bevarer en diskussions bedømmelsesfordeling. Den rangordner ikke alle måder at indsamle feedback på.
Hvis dit spørgsmål er ”Hvordan ser denne diskussion ud som helhed?”, skal du begynde med at definere, hvilke kommentarer der hører til diskussionen. Et tilfældigt udvalg fra en tilgængelig, komplet liste undgår bevidst at favorisere stemmer eller nye oprettelsestidspunkter. I dette arkiv kom det i gennemsnit tættere på, men et lille tilfældigt udvalg havde stadig en målbar afvigelse. 10 var vores valgte antal til sammenligningen, ikke en anbefaling om, at 10 kommentarer er nok.
Hvis dit spørgsmål er ”Hvad skal jeg besvare som det næste?”, kan en bestemt kommentar fortjene opmærksomhed i sig selv. Et klart spørgsmål om at erstatte en ingrediens kan begrunde, at du kontrollerer opskriften og forbereder en forklaring. Du behøver ikke kalde spørgsmålet almindeligt, før du svarer på det. Dets relevans for det næste indhold er en særskilt vurdering.
Hvis dit spørgsmål handler om nylige ændringer, kan oprettelsestidspunktet afgrænse et relevant læsevindue. Gør vinduet tydeligt i opsummeringen. De nyeste kommentarer betød i vores undersøgelse de seneste oprettelsestidsstempler i det gemte arkiv, ikke kommentarer, der kommer i dag, eller den rækkefølge, der aktuelt vises på hjemmesiden.
Selv hele kommentararkivet er en begrænset reference. Det indeholder bidrag fra personer, der valgte at kommentere, frem for alle, der læste eller prøvede en opskrift. Hvis en virksomhed har brug for feedback fra personer, der aldrig kommenterer, kræver det en særskilt måde at nå dem på. Et tættere match med kommentararkivet kan ikke udfylde det hul. Hold den ekstra feedback adskilt, så dens kilde og udvælgelse stadig er forståelige.
Lav 2 særskilte noter: Den ene beskriver det udvalg, der bruges til at opsummere diskussionen; den anden oplister spørgsmål, der er værd at undersøge. Det er et forslag til planlægning, ikke en arbejdsgang testet i undersøgelsen.
Et fiktivt eksempel: planlægning af en opfølgning på en opskrift
Forestil dig en indholdsskaber med fokus på mad, der planlægger en opfølgning på en bageopskrift. En kommentar med mange positive stemmer spørger, om en anden bageform kan bruges. Indholdsskaberen fristes til at åbne den næste video med ”Alle har problemer med formens størrelse”. Det er et fiktivt scenarie, ikke en kommentar eller opskrift valgt fra datasættet.
Spørgsmålet om bageformen kan være værd at besvare uden at vise, hvor almindeligt det er. Positive stemmer fastslår ikke, hvem der prøvede opskriften eller havde samme oplevelse.
En mere præcis brief kunne lyde: ”En læser spurgte, hvordan valget af bageform påvirker denne opskrift. Vis den anvendte form, forklar dimensionerne, og angiv, hvad der skal kontrolleres, før en anden anbefales.” Indholdsskaberen kan derefter verificere detaljerne om bagningen. Kommentaren giver det indledende spørgsmål; den fastslår ikke svaret.
Hvis indholdsskaberen også vil opsummere diskussionen, bør en særskilt note forklare, hvad der blev læst, og hvordan det blev valgt. Et tilfældigt udvalg fra en komplet, tilgængelig liste skal give hver kommentar samme chance uden at vælge samme kommentar 2 gange. At scrolle til nogle få bekvemme steder er ikke den tilfældige procedure, der blev vurderet her.
Når en komplet liste ikke er tilgængelig, skal du beskrive det udvalg, du faktisk kan lave. ”Vi gennemgik de første kommentarer, der blev vist med denne sortering” er mere informativt end at kalde det et repræsentativt udvalg. Knyt ikke vores arkivs numeriske afvigelser til den anderledes proces.
Opfølgningen bør vise udstyret og besvare det kontrollerede spørgsmål. Registrér, hvad du afklarede, så næste gennemgang kan fokusere på ubesvarede spørgsmål. Vurdér forklaringen ud fra feedback på selve opfølgningen.
Hold udvælgelse og fortolkning adskilt
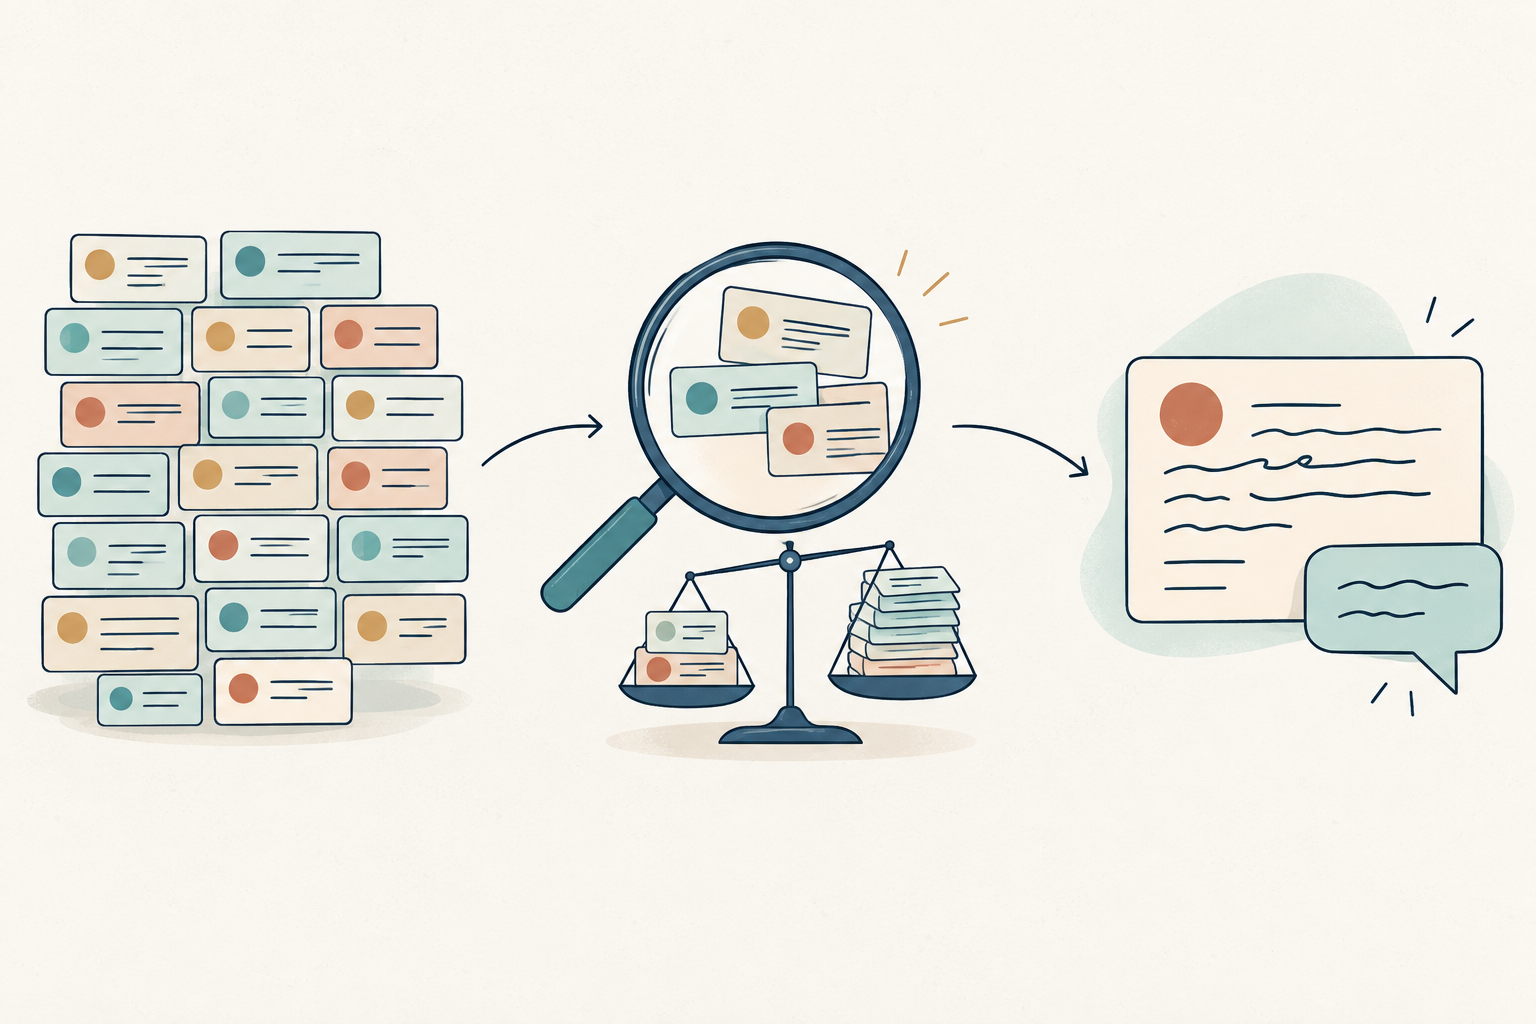
Definér læseudvalget
Angiv diskussionen og udvælgelsesreglen, før du læser.
Overvej, hvad udvalget dækker
Hold det valgte indblik adskilt fra hele diskussionen.
Læs kommentaren i kontekst
Brug det faktiske spørgsmål til at planlægge et svar, og kontrollér svaret.
En kort brief til læsning af en opskriftsdiskussion
Brug disse spørgsmål, før du beder en indholdsskaber eller kollega om at gennemgå kommentarer. De er en praktisk hjælp til planlægningen, ikke spørgsmål fra kildedatasættet.
Beslutning: Hvad skal læsningen danne grundlag for? Angiv en konkret opgave, f.eks. at afklare et opskriftstrin eller vælge et emne til opfølgning. Adskil en anmodning om eksempler fra en anmodning om at beskrive hele diskussionen.
Omfang: Hvilken opskrift, platform og periode indgår? Angiv, om den tilgængelige liste er komplet. Tæl kommentarer som kommentarer; kald dem ikke unikke personer eller verificerede kunder uden særskilt belæg.
Udvælgelse: Hvordan skal kommentarer indgå i læseudvalget? Registrér sorteringsrækkefølgen eller den tilfældige procedure, antallet af læste kommentarer og en eventuel regel ved lighed. Bevar kommentarer uden bedømmelse i omfanget, når de er en del af den diskussion, du vil forstå.
Observationer: Hvad sagde de valgte kommentarer faktisk? Adskil et direkte spørgsmål fra din fortolkning af det. Bevar nok kontekst til at forstå problemet, og hold samtidig personoplysninger ude af en delt brief.
Næste handling: Hvilken påstand eller opskriftsdetalje skal kontrolleres før udgivelse? Giv opgaven til en person, der kan besvare den. Skriv den foreslåede forklaring og destination uden at gøre de valgte eksempler til en udokumenteret påstand om udbredelse.
Sådan sammenlignede vi de 3 udvælgelsesmetoder
Kilden er Ali, Matuszewski og Czupyts datasæt Recipe Reviews and User Feedback, udgivet af UCI i 2023 under CC BY 4.0. Det indeholder kommentarer fra en udvalgt liste med 100 højt bedømte Taste of Home-opskrifter. Udgivelsesåret fastslår ikke en præcis indsamlingsdato, og det tilgængelige kildemateriale fastslår ikke, at alle oprindelige kommentarer blev indsamlet. Det er en analyse af et historisk arkiv, ikke et aktuelt platformbenchmark. [1][2][3]
Vi validerede hele det udgivne arkiv: 18.182 forskellige kommentaridentifikatorer på tværs af 100 opskriftspositioner. Hver opskrift havde mere end 10 kommentarer, så alle 100 indgik i sammenligningen. Flere kommentarer fra samme person tælles fortsat som flere kommentarer. Vi deduplikerede ikke efter person og analyserede ikke anmeldelsestekst, navne, brugeromdømme eller kildens rangeringsscore.
For hver opskrift valgte reglen om positive stemmer de 10 kommentarer med de højeste observerede antal positive stemmer. Reglen om nyeste kommentarer brugte de 10 seneste oprettelsestidsstempler. Ved lighed på grænsen var alle mulige måder at udfylde de resterende pladser fra den lighed lige sandsynlige. Tilfældig udvælgelse gav hvert udvalg på 10 kommentarer fra opskriftens arkiv samme sandsynlighed.
For hvert muligt udvalg sammenlignede vi dets bedømmelsesfordeling i 6 kategorier med hele opskriftsarkivet og tog derefter gennemsnittet af afstanden under udvælgelsesreglen. Præcise sandsynlighedsberegninger giver den forventning uden simulering. Det er vigtigt at tage gennemsnittet af afstandene: En afstand beregnet først efter gennemsnittet af kategoriandelene ville besvare et andet spørgsmål og kunne skjule udvælgelsesvariation.
Derefter tog vi gennemsnittet af de opskriftsspecifikke forventede afstande med samme vægt for hver opskrift. Forskelle blev beregnet før afrunding til 1 decimal. Antallet på 10 kommentarer, reglerne for at indgå, sammenligningerne og rapporteringsplanen blev fastlagt, før målresultaterne blev undersøgt. Der blev ikke efterfølgende valgt et andet antal eller et gunstigt deludvalg af opskrifter.
Resultaterne beskriver dette afgrænsede arkiv og de angivne udvælgelsesregler, så vi rapporterer ikke et konfidensinterval for populationen eller en årsagsvirkning. Samlede positive stemmer afslører ikke eksponering eller stemmehistorik. Den oprindelige producents artikel undersøger tekstklassifikation; denne analyse følger i stedet UCIs dokumenterede stjernekategorier og undersøger udvælgelse. Den tekniske metode forklarer forskellen mellem kildefelterne. [1][2]
Downloadfilerne indeholder de aggregerede resultater, en numerisk gennemgang for hver opskriftsposition og kode til at reproducere analysen. De indeholder ikke kommentartekst, navne eller brugeridentifikatorer. Kilderegistreringerne findes separat hos UCI; kreditering af datasættets forfattere og repositoriet betyder ikke, at de godkender vores fortolkning. [1][3]
Ingen tilmelding nødvendig. Downloadmaterialet indeholder aggregerede sammenligninger, numeriske resultater efter opskriftens placering og oversatte metodeforklaringer. Ingen kommentartekst, brugernavne eller individuelle kommentaridentifikatorer medfølger. Kildedatasættet kan hentes særskilt fra UCI. [1]
Kilder og noter
- Ali, A., Matuszewski, S. og Czupyt, J. (2023). Recipe Reviews and User Feedback [datasæt]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI dokumenterer 18.182 kommentarer og definerer stjerner fra 1–5, hvor 0 betyder ingen bedømmelse. Influence IQs beregninger bruger det udgivne arkiv, ikke aktuelle hjemmesidedata.
- Dataproducentens artikel, ”Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models”, beskriver den udvalgte opskriftskilde og en undersøgelse af tekstklassifikation. Dens beskrivelse af best_score strider mod UCIs dokumenterede bedømmelsesfelt. Vi bruger stars og analyserer ikke best_score eller anmeldelsestekst. Det tilgængelige materiale fastslår ikke et præcist tidspunkt for øjebliksbilledet eller fuldstændig indsamlingsdækning.
- UCI-datasættet er licenseret under Creative Commons Attribution 4.0. Influence IQ har beregnet nye aggregerede sammenligninger ud fra det. Kreditering af datasættet betyder ikke godkendelse fra forfatterne, UCI eller Taste of Home. Downloadfilerne videredistribuerer ikke individuelle kommentarer eller brugeridentiteter.
- Influence IQ (2026). Udvælgelse af opskriftskommentarer: analysemetode, aggregerede resultater og reproduktionskode. Pakken dokumenterer den fastlagte sammenligning med 10 kommentarer, de præcise beregninger af forventet totalvariation, håndteringen af ens værdier og de numeriske resultater for alle 100 opskriftsplaceringer. Kildedataene hentes særskilt fra UCI. De oprindelige tekniske filer ledsages af oversatte forklaringer.
Artiklen, planlægningsbriefen, figurlabels og CSV-filen med resultater findes på alle artiklens sprog. Den tekniske reproduktionspakke indeholder oversatte forklaringer. Alle udgaver beskriver det samme historiske opskriftsarkiv og den samme analyse.