To moderationsetiketter kan komme fra forskellige bedømmere
En overlevering ved kommentargennemgang kan vise to etiketter uden at vise, hvem der valgte dem. Historiske Wikipedia-vurderinger viser, hvorfor den oplysning er vigtig for den næste, der læser sagen.
Original analyse fra Influence IQ af udvalgte vurderinger i det historiske datasæt Wikipedia Detox om personangreb. Analysen blev afsluttet 25. oktober 2026 (UTC).
Resumé
Blandt 13.824 udvalgte historiske uddrag fra Wikipedia-diskussioner fik 155 både etiketten citat/referat og etiketten angreb rettet mod modtageren et eller andet sted i deres 10 individuelle vurderinger. I 98 af disse 155 uddrag valgte mindst én bedømmer begge etiketter. I de øvrige 57, eller 36,8 %, kom etiketterne kun fra forskellige bedømmere. Procenten beskriver de 155 uddrag, ikke alle 13.824.[1][4]
For virksomheder og indholdsskabere, der håndterer kommentarer på sociale medier, handler den praktiske lære om overleveringen: Bevar hver bedømmers observationer sammen med personens vurdering. At to etiketter optræder sammen, beviser ikke, at én person valgte begge. Studiet beskriver subjektive vurderinger af historiske diskussionsuddrag, ikke moderationsfejl eller en regel for at fjerne en kommentar. Skemaet nedenfor kan kopieres og omsætter skellet til en praktisk registrering af gennemgangen.
Forestil dig, at en indholdsskaber beder en kollega se på en vanskelig kommentar. Overleveringen indeholder to etiketter: Nogen citerer eller refererer et angreb, og nogen retter et angreb mod modtageren. Før kollegaen beslutter, hvad der skal ske, mangler én oplysning: Var det den samme bedømmer, der gjorde begge observationer?
Det er et reelt skel, som kan gå tabt i et resumé. Én person kan have valgt begge muligheder, eller to personer kan have fokuseret på forskellige sider af samme tekst. En liste over etiketter kan ikke alene fortælle den næste bedømmer, hvilket mønster der forekom. Den kan også efterlade tvivl om, hvilke ord hver person beskrev.
Vi undersøgte spørgsmålet med individuelle vurderinger fra et etableret forskningsdatasæt. Det oprindelige materiale kom fra Wikipedias diskussionssider. Her skal det synliggøre forholdet mellem etiketter og bedømmere og hjælpe en virksomhed eller indholdsskaber med at overveje, hvilke oplysninger der bør bevares i deres egen overlevering.
Bevar hver observation sammen med dens bedømmer
Begynd med, hvad hver etiket faktisk beskriver
Den første mulighed spurgte, om teksten citerede eller refererede et personangreb fra en anden kommentar. Den anden handlede om et personangreb rettet mod modtageren. Bedømmerne kunne vælge mere end én mulighed. Det var vurderinger af den viste tekst, ikke beslutninger om at skjule den eller bevis for, at en regel var overtrådt.[2]
Vi regnede en etiket som til stede, når mindst én af de 10 bedømmere valgte den. Sammenligningen byggede altså på valg fra en hvilken som helst bedømmer. Vi krævede ikke flertal, kaldte ikke etiketterne konsensus og testede ikke, om de var korrekte.
Af de 13.824 udvalgte uddrag havde 12.025 ingen af disse to etiketter. Yderligere 406 havde en citat-/referatetiket uden en modtagerrettet etiket, mens 1.238 havde en modtagerrettet etiket uden en citat-/referatetiket. Dermed var der 155 med begge etiketter et eller andet sted i vurderingerne.
Beskrivelserne gælder kun disse to muligheder. Et uddrag uden en modtagerrettet etiket kunne stadig have en anden type angrebsetiket. En citat-/referatetiket bekræfter ikke, at teksten var harmløs. Præcise navne forhindrer, at en nyttig kategori umærkeligt bliver til en bredere konklusion.
Sådan blev de 13.824 udvalgte uddrag mærket
En etiket talte som til stede, hvis mindst én af de 10 bedømmere valgte den. De fem kategorier vedrører to bestemte muligheder; ”ingen af dem” betyder ikke, at uddraget manglede enhver form for angrebsetiket.
| Etiketter for citat/referat og angreb mod modtageren | Uddrag |
|---|---|
| Ingen af disse to etiketter | 12.025 |
| Citat/referat uden angreb mod modtageren | 406 |
| Angreb mod modtageren uden citat/referat | 1.238 |
| Begge etiketter med mindst ét par fra samme bedømmer | 98 |
| Begge etiketter, kun valgt af forskellige bedømmere | 57 |
57 uddrag havde begge etiketter, men ingen bedømmer valgte begge
For de 155 uddrag kontrollerede vi det individuelle svar bag hver etiket. I 98 valgte mindst én person begge muligheder for samme uddrag. I 57 kom valgene af citat/referat og angreb mod modtageren kun fra forskellige personer. Intet individuelt svar i de 57 indeholdt parret.
Fordelingen var 63,2 % med et par fra samme bedømmer og 36,8 % med etiketter fra forskellige bedømmere alene. Begge grupper tilhørte det samme snævert definerede sæt på 155 uddrag. Den større ramme på 13.824 uddrag er stadig vigtig, fordi den viser udgangspunktet for den betingede sammenligning.[4]
Skellet ændrer, hvad du kan hævde ud fra et resumé. At begge etiketter forekom, giver grundlag for at sige, at hver af dem blev valgt et sted i sættet af vurderinger. Det giver ikke i sig selv grundlag for at sige, at én bedømmer beskrev teksten på begge måder.
Et mønster med samme bedømmer afgør heller ikke, hvad ordene betød. Et kildeuddrag kunne samle tilføjelser fra én Wikipedia-revision, herunder mere end ét opslag. At én bedømmer valgte begge muligheder, viser ikke, at selve det citerede stykke var angrebet mod modtageren. Vi gennemgik ikke de enkelte uddrag for at forklare vurderingerne.[2][6]
57 af de 155 uddrag havde intet par fra samme bedømmer
Sammenligningen omfatter kun de 155 udvalgte uddrag med begge etiketter et sted i deres 10 vurderinger. Den bruger valg fra en hvilken som helst bedømmer, ikke flertalsenighed eller verificerede moderationsresultater.
| Hvem valgte de to etiketter? | Uddrag | Andel af de 155 uddrag |
|---|---|---|
| Mindst én bedømmer valgte begge | 98 | 63,2 % |
| Etiketterne kom kun fra forskellige bedømmere | 57 | 36,8 % |
Giv den næste bedømmer observationen bag etiketten
I en virksomhed kan sagen gå fra den, der følger kommentarerne, til den kontoansvarlige. Hos en indholdsskaber kan den gå fra en assistent til indholdsskaberen selv. Den næste person skal forstå, hvad der blev bemærket, før vedkommende beslutter at svare, søge mere kontekst eller bruge kontoens eksisterende regler.
Hold hver persons valg samlet. Hvis en bedømmer vælger begge muligheder, skal parret bevares som personens vurdering. Hvis to bedømmere vælger forskellige muligheder, skal de separate svar bevares. En sag kan rumme mere end én læsning, uden at de omdannes til en vurdering, ingen faktisk har foretaget.
Tilføj derefter en kort forklaring af det relevante tekststykke. Angiv i din egen arbejdsgang, hvad der ser ud til at være citeret, hvem der ser ud til at blive tiltalt, og hvilket omgivende svar der hjælper med at forklare udvekslingen. Lad usikkerheden stå synligt, når den tilgængelige kontekst ikke besvarer spørgsmålet. Det er praktiske forslag; datasættet testede ikke deres virkning på beslutninger.
En kort note kan være nok. Målet er, at den næste person kan følge den første persons ræsonnement uden at genskabe hele gennemgangen. For et team, der giver sager videre mellem vagter eller mellem et brand og en indholdsskaber, betyder det, at både den oprindelige observation og dens kategori følger med.
Et fiktivt eksempel med samme antal etiketter
Forestil dig to opdigtede bedømmerpaneler, hver med 10 personer, der vurderer ét fiktivt uddrag. Panelerne illustrerer regnestykket; de er ikke faktiske personer, citater eller sager fra datasættet. Begge resuméer viser ét valg af citat/referat og ét valg af angreb mod modtageren.[8]
I det første panel vælger bedømmer A begge muligheder. De øvrige 9 vælger ingen af disse to muligheder. Der er én person, hvis svar indeholder parret. En overlevering kan præcist bevare personens samlede vurdering og lade den endelige handling være en særskilt beslutning.
I det andet panel vælger bedømmer A citat/referat, og bedømmer B vælger angreb mod modtageren. De resterende 8 vælger ingen af mulighederne. Felternes totaler er stadig én og én, men ingen person valgte begge. At kalde det én persons samlede vurdering ville tilføje en forbindelse, som de individuelle svar ikke indeholder.
Eksemplet forklarer også, hvorfor vi talte uddrag frem for at lægge alle matchende personer sammen. Hvis to personer i det første panel hver havde valgt begge etiketter, ville uddraget stadig kun tælle én gang i gruppen med samme bedømmer. Klassifikationen spørger, om et sådant par fandtes, ikke hvor mange personer der leverede det.
For det andet panel kunne en kort, fiktiv overlevering lyde: ”Beslutningen er stadig åben. Bedømmer A identificerede citat/referat; bedømmer B identificerede sprog rettet mod modtageren. Bevar begge noter sammen med uddraget og det tidligere svar. Den kontoansvarlige vil undersøge, hvilken passage hver bedømmer mente, før handlingen vælges.” Noten giver et uafklaret spørgsmål videre uden at omskrive to personers svar til én persons konklusion.
Ved en faktisk overlevering skal du bevare de to separate noter fra det andet panel. Den næste bedømmer kan læse dem sammen med teksten, spørge, hvad hver person mente, og træffe beslutningen ud fra kontoens regler. Studiet fastslår ikke, om nogen af bedømmerne havde ret, eller hvilken handling den fiktive sag bør føre til.
Samme antal etiketter kan komme fra forskellige vurderingsmønstre
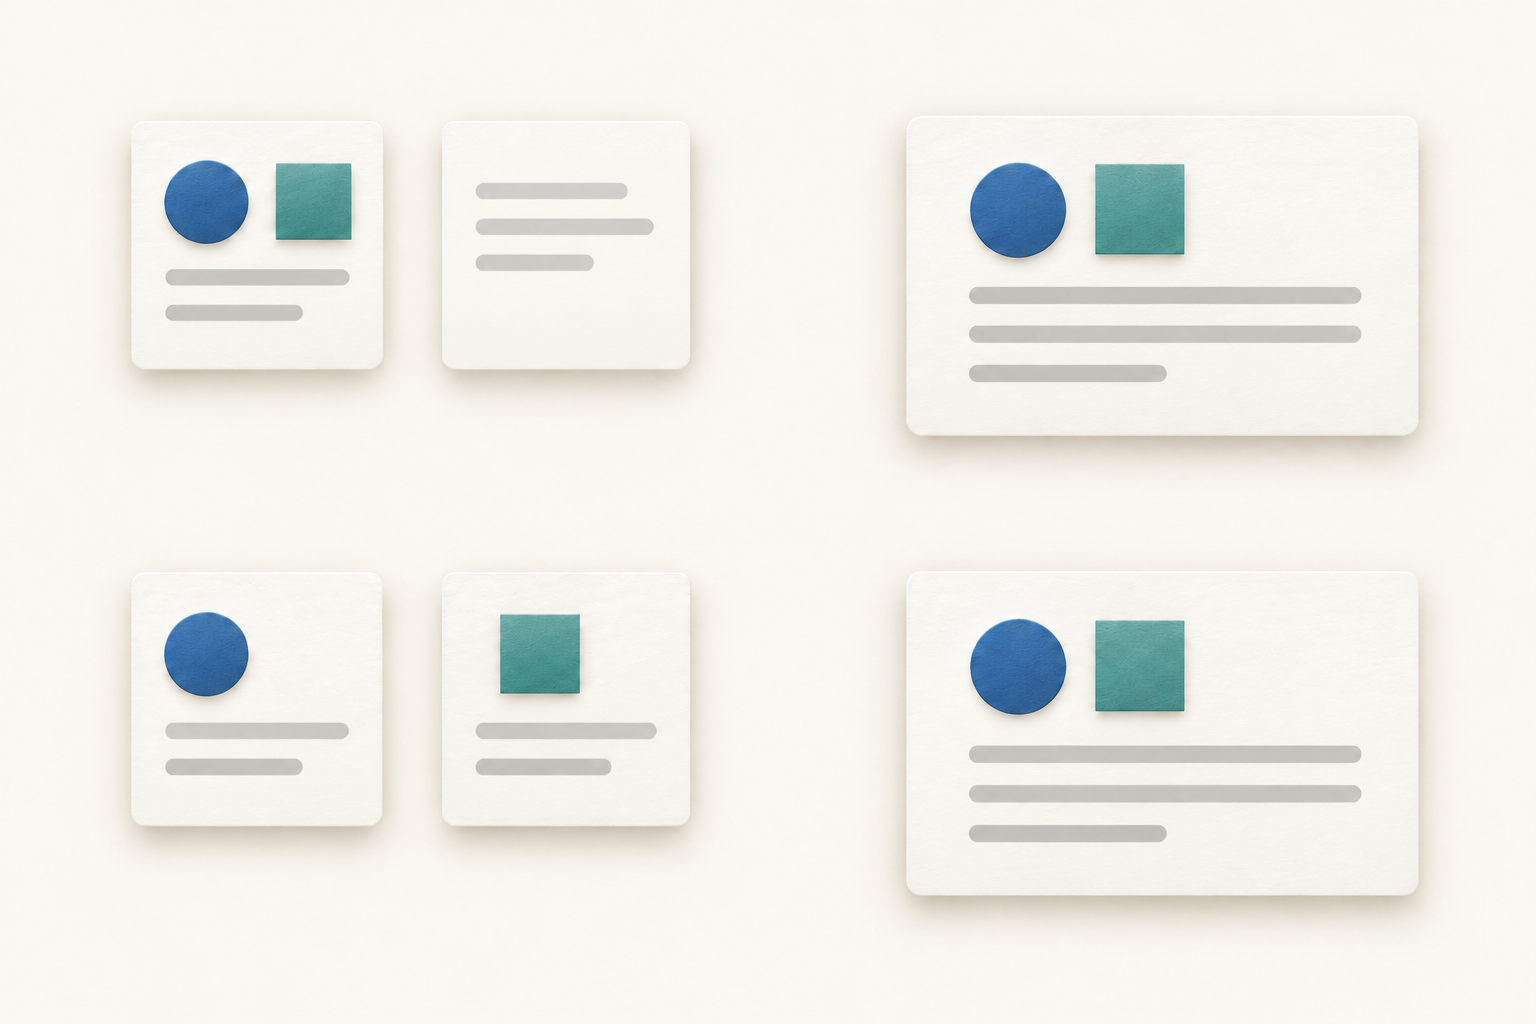
Én bedømmer vælger begge
Det første opdigtede panel har én person, der vælger begge etiketter, og 9, der ikke vælger nogen af disse to muligheder.
To bedømmere vælger én hver
I det andet vælger én person citat/referat, og en anden vælger angreb mod modtageren. De øvrige 8 vælger ingen af mulighederne.
Hold beskrivelsen og beslutningen ud fra reglerne adskilt
En beskrivelse af, hvad der ser ud til at stå i en kommentar, og en beslutning om, hvad der skal ske med den, har forskellige formål. En bedømmer kan bemærke citeret sprog, mens den kontoansvarlige stadig skal overveje den omgivende udveksling og de gældende regler. Bevar trinnene hver for sig, så en senere læser kan se, hvordan beslutningen blev truffet.
En virksomhed, der arbejder med en indholdsskaber, bør aftale, hvem der træffer beslutningen, før en vanskelig udveksling opstår. Den, der forstår en produktklage, er ikke nødvendigvis den, der må ændre kontoens moderationstilgang. En tydelig overlevering kan angive begge roller uden at forudsætte, at alle sager kræver flere bedømmere.
For en indholdsskaber, der arbejder alene, kan det samme skel stå i én note: Hvad bemærkede du, hvilken kontekst kontrollerede du, og hvad besluttede du? Én person kan udføre flere trin og stadig holde deres formål tydelige. Datasættet viser ikke, at mere personale eller et ekstra gennemgangsled forbedrer resultaterne.
Hold separate observationer adskilt, indtil du forstår deres sammenhæng. Forskellige valg kan afspejle forskelligt fokus frem for modstridende beskrivelser. Et valg af citat/referat er ikke en automatisk undtagelse, og et valg af angreb mod modtageren er ikke en målt anbefaling om at slette. Den nyttige næste handling er den, der understøttes af den faktiske udveksling og kontoens regler, frem for en handling udledt af vores arkivprocenter.
Et skema til kommentargennemgang, du kan kopiere
Kopiér felterne til dit eksisterende dokument til gennemgang eller overlevering. Brug kun de oplysninger, dit team har behov for, og giv adgang, der passer til samtalen. Skemaet er tilgængeligt her uden tilmelding; det er praktisk vejledning og ikke en observeret proces fra studiet.[8]
Sag: [Link eller intern reference.] Konto/kanal: [Hvor udvekslingen findes.] Kontrolleret: [Dato og klokkeslæt.] Bevar en fast reference, så den næste person kan finde samme materiale.
Formål: [Hvilket spørgsmål kræver en beslutning?] Ansvarlig: [Hvem beslutter?] Næste person: [Hvem skal eventuelt have sagen overleveret?]
Vist tekst: [Passagen, der gennemgås, opbevaret i jeres godkendte arbejdsområde.] Omgivende kontekst: [Relevante tidligere eller senere svar.] Manglende kontekst: [Det, der ikke kunne kontrolleres.]
Bedømmer: [Navn eller intern reference til bedømmeren.] Vurderingstidspunkt: [Dato og klokkeslæt.] Hold hver persons registrering adskilt, også når flere bruger samme etiketter.
Observation af citat/referat: [Ja, nej eller uklart.] Grundlag: [Hvilken passage ser ud til at citere eller referere en anden persons angreb?] Brug ikke feltet til at afgøre, om teksten er harmløs.
Observation rettet mod modtageren: [Ja, nej eller uklart.] Grundlag: [Hvilken passage ser ud til at være rettet mod modtageren, og hvorfor?] Hold svaret uafhængigt af observationen af citat/referat.
Andre relevante observationer: [Andre forhold, der skal indgå ud fra kontoens regler.] Behandl ikke fraværet af en af studiets to etiketter som en fuldstændig beskrivelse af udvekslingen.
Forholdet mellem vurderingerne: [Én person valgte begge, forskellige personer valgte forskellige muligheder, eller uklart.] Hvis det er forskellige bedømmere, skal deres individuelle noter bevares, før sagen opsummeres.
Henvisning til regler: [Den gældende regel eller vejledning.] Beslutning: [Den handling, der faktisk blev valgt, eller det uafklarede spørgsmål.] Begrundelse: [Hvordan observationen og konteksten understøtter beslutningen.]
Opfølgning: [Hvem gør eventuelt hvad som det næste?] Overleveringstidspunkt: [Hvornår sagen går videre til personen.] Resultat: [Hvad skete efter beslutningen, hvis det er kontrolleret?] Markér ikke en planlagt handling som gennemført.
Gennemgå igen, når: [En bestemt hændelse eller manglende kontekst, hvis der er behov for endnu et kig.] Skemaet kræver ikke gentagen gennemgang af alle sager; brug en grund, der passer til situationen.
Kontrollen af årstal beholdt de samme 155 uddrag
Vi fastlagde to supplerende kontroller, før vi beregnede etiketparrene. Den første udelod uddrag dateret 2016, fordi de frigivne filers årsspænd gik ud over perioderne i kildeoversigten og den oprindelige artikel. Tilbage var 13.809 kvalificerede uddrag fra den tilfældige stikprøve. De samme 155 havde begge etiketter med samme fordeling på 98/57.[5]
Den anden kontrol brugte datasættets særskilt udvalgte materiale fra omkring blokeringer. Med samme regel om præcis 10 vurderinger omfattede det 42.383 uddrag. Af de 2.457 med begge etiketter et sted havde 1.354 et par fra samme bedømmer, og 1.103 havde kun etiketter fra forskellige personer: henholdsvis 55,1 % og 44,9 %.
Gruppen med ekstra materiale omkring blokeringer har et andet udvælgelsesformål, så vi holdt den adskilt. Dens procenter erstatter ikke hovedresultatet og bliver ikke til evidens om aktuelle kommentarer til brands. Årstalskontrollen vedrører det registrerede datospænd; ingen af kontrollerne fjerner behovet for at fortolke resultaterne som subjektive vurderinger af udvalgte historiske uddrag.
Sådan faldt de to forudvalgte kontroller ud
Hver række bruger præcis 10 fuldstændige vurderinger pr. uddrag. Stikprøven med ekstra blokeringstilfælde har sit eget udvælgelsesformål. Udelukkelse af 2016 vedrører en forskel mellem de frigivne filers årsspænd og kildebeskrivelserne.
| Forudvalgt sammenligning | Kvalificerede uddrag | Uddrag med begge etiketter et sted | Med et par fra samme bedømmer | Kun forskellige bedømmere | Andel af uddrag med begge etiketter, kun fra forskellige bedømmere |
|---|---|---|---|---|---|
| Tilfældig stikprøve, præcis 10 vurderinger | 13.824 | 155 | 98 | 57 | 36,8 % |
| Stikprøve med ekstra blokeringstilfælde, holdt adskilt | 42.383 | 2.457 | 1.354 | 1.103 | 44,9 % |
| Tilfældig stikprøve uden 2016 | 13.809 | 155 | 98 | 57 | 36,8 % |
Sådan sporede vi etiketterne tilbage til individuelle vurderinger
Vi brugte version 6 af Wikipedia Talk Labels: Personal Attacks, et offentligt datasæt fra projektet Wikipedia Detox. De frigivne filer indeholder tekst fra historiske revisioner af diskussionssider og flere vurderinger fra personer, der udførte opgaven via crowdsourcing, for hvert uddrag. Analysen brugte de individuelle svar; den skabte ikke nye vurderinger og evaluerede ikke et moderationssystem.[1][2]
Hovedsammenligningen begyndte med udgivelsens tilfældige stikprøve og beholdt uddrag med præcis 10 forskellige, fuldstændige vurderinger. Det faste antal på 10 gav hvert uddrag lige mange muligheder for at få et parret valg. Samtidig udvalgte det 13.824 af de 37.492 frigivne uddrag i den tilfældige stikprøve, så resultatet beskriver ikke hele gruppen.[3]
Hvert udvalgt uddrag talte én gang. Vi kontrollerede, om en af etiketterne forekom noget sted, og derefter om begge fandtes i én persons svar til samme uddrag. De fem kategorier er gensidigt udelukkende og summerer til 13.824. Nævneren på 155 uddrag kommer fra de to kategorier med begge etiketter, ikke fra alle vurderinger eller alle kildeuddrag.[4]
Før vi så på parrene, fastlagde vi stikprøvegrupperne, dækningsreglen, årstalskontrollen og et minimum på 100 uddrag i den primære betingede sammenligning. De observerede 155 opfyldte kravet. Vi fastsatte ikke en krævet procent, ændrede ikke reglen for at favorisere et resultat og lagde ikke materialet med ekstra blokeringstilfælde sammen med den tilfældige gruppe.
Den oprindelige forskning brugte allerede individuelle vurderinger, og senere arbejde samlede hvert angrebsfelt ved flertalsvalg. Vores snævrere bidrag er denne beskrivende sammenligning af, hvem der valgte de to muligheder inden for et fast sæt vurderinger. Det er ikke en rettelse af de studiers metoder. Downloaden indeholder samlede resultater, metoder og reproduktionsvejledning, som bruger de offentlige kildefiler, der er tilgængelige separat.[6][7]
Gør den næste gennemgang lettere at følge
Det nyttige spørgsmål ved overlevering af en moderationssag på sociale medier er, hvem der gjorde hver observation, og hvad de beskrev. I denne sammenligning af udvalgt arkivmateriale havde 57 af 155 uddrag med begge etiketter ingen individuel bedømmer, der valgte parret. Den forbindelse ville gå tabt i et resumé med kun de to etiketnavne.
Bevar forbindelsen mellem personens observationer, den relevante kontekst og den endelige beslutning. En virksomhed eller indholdsskaber kan så forklare, hvad sagen indeholder, og hvorfor den valgte handling følger af det, uden at lade en kategorietiket gøre hele gennemgangens arbejde.
Ingen tilmelding kræves. Pakken indeholder anonyme, samlede resultater, metoder, reproduktionsvejledning og det genanvendelige skema. Den indeholder ingen oprindelig diskussionstekst, revisions-ID’er, opgaveløser-ID’er eller demografiske oplysninger. De oprindelige offentlige kildefiler findes separat i den linkede udgivelse.
Kilder og noter
- Kilde: Wikipedia Talk Labels: Personal Attacks, Figshare version 6, DOI 10.6084/m9.figshare.4054689.v6, udgivet i februar 2017 under CC0. Vi brugte attack_annotated_comments.tsv (fil 7554634) og attack_annotations.tsv (fil 7554637), med producentens MD5 og uafhængigt beregnede SHA-256-kontroller. Influence IQ afsluttede udvælgelsen, beregningerne og fortolkningen 25. oktober 2026 (UTC). Studiet indsamlede ikke nye kommentarer, skabte ikke nye annoteringer og målte ikke en aktiv social platform.
- Producenten definerer quoting_attack som en opgaveløsers opfattelse af, at teksten citerer eller refererer et angreb fra en anden kommentar, og recipient_attack som et angreb rettet mod modtageren. Grænsefladen tillod flere valg. Generelt angreb er et separat kildesvar, ikke et OR-udtryk rekonstrueret fra undertyper i denne analyse. Den frigivne tekst sammenkæder tilføjelser fra en revision; den er ikke en redigeringsbeskrivelse, nødvendigvis ét helt opslag eller en komplet samtale. Diskussionernes navnerum, stikprøvegrupper og opdelinger til træning, udvikling og test af modellen bevarer deres dokumenterede betydning.
- De komplette filer indeholdt 115.864 unikke uddrag, 1.365.217 unikke par af revision og opgaveløservurdering samt 4.053 opgaveløsere. Den strukturelle kontrol fandt ingen dublerede par, koblinger uden match, fejlformede rækker eller manglende/ugyldige flagværdier. Udvælgelsen krævede præcis 10 forskellige, fuldstændige vurderinger på tværs af alle 5 kildeflag, begge dokumenterede diskussionsnavnerum og alle modelopdelinger, med én ligevægtet optælling pr. uddrag. Den primære tilfældige gruppe beholdt 13.824 af 37.492 uddrag. Gruppen med ekstra materiale omkring blokeringer, der blev udvalgt separat, beholdt 42.383 af 78.372. Samme opgaveløser på forskellige uddrag var tilladt; vi foretog ingen sammenlægning af identisk tekst, sletning ud fra sammenhæng mellem flag eller omkodning af generelt angreb.
- Lad Q betegne et hvilket som helst valg af citat/referat og R et hvilket som helst valg af angreb mod modtageren for et kvalificeret uddrag. Forekomst af begge kræver mindst ét Q og ét R et sted blandt de 10 vurderinger. Forekomst hos samme bedømmer kræver desuden Q og R i ét svar fra samme revisions-/opgaveløserpar; forekomst kun hos forskellige bedømmere har intet sådant svar. Den primære betingede nævner er 98 + 57 = 155; de præcise brøker 98/155 og 57/155 vises som 63,2 % og 36,8 %. Procenterne bruger præcis brøkregning og afrunding opad ved halve værdier til 1 decimal. Før beregningen af parrene krævede vi mindst 100 uddrag med begge etiketter i hovedsammenligningen uden nogen tærskel for en fordelagtig procent. Der blev ikke angivet noget konfidensinterval for populationen, foretaget nogen signifikanstest, fremsat nogen påstand om uafhængighed eller beregnet noget estimat af nøjagtighed.
- Den på forhånd fastlagte følsomhedskontrol med ekstra blokeringstilfælde brugte samme regel om præcis 10 vurderinger og blev holdt adskilt fra den primære tilfældige stikprøve. Dens fem antal var 20.911 uden nogen af etiketterne, 959 med citat/referat uden modtagerrettet angreb, 18.056 med modtagerrettet angreb uden citat/referat, 1.354 med begge fra samme bedømmer og 1.103 med begge kun fra forskellige bedømmere; i alt 42.383 og en betinget nævner på 2.457. Udelukkelse af 2016 fra den primære tilfældige stikprøve efterlod 13.809 uddrag med fem antal på 12.012 / 406 / 1.236 / 98 / 57 i samme rækkefølge. De 155 betingede uddrag og parfordelingen på 98/57 var uændret. Det er beskrivende kontroller, ikke uafhængige gentagelser for populationen eller evidens for, at stikprøvegrupperne er sammenlignelige.
- Wulczyn, Thain og Dixons Ex Machina: Personal Attacks Seen at Scale fra 2017 etablerede det underliggende arbejde med crowdsourcing og modellering. Cécillon og kollegers WAC-artikel fra 2020 bevarede en matrix med opgaveløsere pr. felt og samlede angrebsfelterne separat ved flertalsvalg. Det er eksisterende metoder, ikke fejl fastslået af dette studie. Vores sammenligning bruger etiketforekomst hos mindst én af 10 og par i samme svar, ikke præstationen af flertalsvalgte etiketter. Influence IQ tæller, om de to muligheder blev valgt af samme bedømmer eller kun af forskellige bedømmere inden for hvert udvalgt uddrag.
- Kildeoversigten beskriver 2001–2015 og den oprindelige artikel 2004–2015; de fastlåste filer i version 6 indeholder årstal fra 2001–2016. Producentens skema for loginstatus siger 0/1, mens den frigivne fil bruger False/True; binære flagstrenge er 0.0/1.0. Vi bevarede disse forskelle mellem dokumentation og observation uden at angive en årsag. Parseren accepterer de præcise frigivne literaler uden at afrunde eller konvertere etiketværdier. Pakken dokumenterer kildeversioner, udvælgelsesregler og trinene til at gentage analysen ud fra de offentlige filer.
- De to bedømmerpaneler med 10 personer, svarene fra bedømmer A/B og valgene ved overlevering er fiktive undervisningseksempler. De indeholder ingen oprindelig diskussionstekst eller identifikatorer fra datasættet. Begge opdigtede paneler har ét valg af citat/referat og ét valg af angreb mod modtageren, men kun det første har et par fra samme person. Skemaet og de konceptuelle illustrationer er praktiske forklaringer, ikke observerede arbejdsgange i kilden, testede moderationsregler eller garantier for bedre beslutninger.
Alle sprogversioner er oversat direkte fra den engelske kilde. Hver udgave beskriver samme historiske datasæt fra den engelsksprogede Wikipedia og de samme udvalgte vurderinger. Oversættelsen skaber ikke resultater for lokale markeder. Influence IQ er ansvarlig for analysen, fortolkningen og oversættelserne.