عرض منتجات التجارة الإلكترونية: اختبر افتراضاتك عن موضع المنتج
توضح تجربة تاريخية تضم 10 كتب كيف قد يغفل تعديل بسيط للموضع أجزاء من النمط، وكيف تختبر ذلك الافتراض قبل مقارنة بطاقات المنتجات.
إعادة تحليل أصلية للتجربة المنشورة لاختيار الكتب عام 2024، من إعداد Compiani وMorozov وSeiler.
الملخص
قبل الحكم بأن عرضا أقوى من آخر، تحتاج الشركة إلى مراعاة موضع ظهور كل منهما. استخدمنا تجربة منشورة لعام 2024 تضم 10 كتب إلكترونية لاختبار طريقتين (2) لمراعاة الموضع. كان السماح بتعديل خاص لكل موضع أفضل إجمالا في التنبؤ بالاختيارات من تطبيق التعديل نفسه لكل خطوة إلى أسفل القائمة. لكنه كان أقل دقة في بعض المواضع الفردية، ولذلك تهم المقارنة الكاملة.
استخدم النموذجان معلومات الكتب والأسعار نفسها. دربناهما على 6,176 مشاركا، وتحققنا من تنبؤاتهما على 3,088 مشاركا آخر. كانت الاختيارات افتراضية، وكان على الجميع اختيار كتاب. بالنسبة إلى الشركات وصناع المحتوى الذين يقارنون بطاقات المنتجات، يتمثل الدرس في اختبار افتراضات الموضع قبل إسناد النتائج إلى العرض. لا تقدر الدراسة زيادة في المبيعات أو تحدد أفضل ترتيب للمنتجات.
افترض أن المنتج في أعلى صفحة يحصل على أكبر عدد من النقرات. هل عرضه أقوى، أم ساعده موضعه في القائمة؟ تحتاج الشركة إلى إجابة مفيدة قبل إعادة كتابة البطاقات الأخرى، أو تخفيض أسعار العناصر التي تبدو أضعف، أو تغيير التشكيلة.
تبدو مراعاة الموضع بسيطة حتى تسأل عن الكيفية. هل ينبغي أن تخضع كل خطوة إلى أسفل القائمة للتعديل نفسه؟ استخدمنا تجربة تاريخية لمقارنة ذلك النهج البسيط بآخر أكثر مرونة، ثم اختبرنا كليهما على مشاركين لم تُستخدم اختياراتهم في تدريب النموذجين.
المنتجات نفسها في مواضع مختلفة
ما الذي ينبغي أن توضحه مقارنة مواضع المنتجات؟
ينبغي أن تساعدك مقارنة بطاقات المنتجات على الفصل بين العنصر المعروض وطريقة تقديمه. إذا كان منتج يظهر أولا عادة وآخر يظهر أخيرا عادة، فلا تجيب إجمالياتهما وحدها عما إذا كان المتسوقون يفضلون أحد العرضين.
يمنح النهج البسيط الذي نختبره كل خطوة إلى أسفل القائمة التعديل نفسه على درجة التفضيل الكامنة في النموذج. والسؤال المفيد هو مدى كفاية دقة تنبؤاته بالاختيارات، مقارنة بالسماح بتعديلات مختلفة للمواضع المختلفة.
اختبرنا هذين النهجين (2) باستخدام تجربة منشورة لاختيار الكتب. تهم النتيجة الشركات وصناع المحتوى الذين يقارنون منتجات في صفحة مجموعة أو واجهة متجر رقمي. وهي تقدم طريقة لفحص افتراض قياس، لا قاعدة لتحديد مكان المنتج الأكثر مبيعا.
يهم هذا عندما يظهر العرض في أكثر من مكان. فقد يبرز صانع محتوى التنزيل نفسه في مجموعة وصفحة إطلاق، وقد يغير تاجر تجزئة ترتيب قائمة فئة. يمكن أن يتغير العنصر والسعر والجمهور وطريقة العرض معا. تعديل الموضع افتراض يتعلق بجزء من تلك المقارنة، ويستحق فحصا مستقلا.
ماذا اختار الناس في تجربة الكتب؟
طلب Giovanni Compiani وIlya Morozov وStephan Seiler من أشخاص استُقطبوا عبر Prolific اتخاذ اختيارات افتراضية من بين 10 كتب إلكترونية، بترتيب وأسعار عشوائية. كان على المشاركين اختيار كتاب؛ ولم يوجد خيار عدم شراء شيء. نستخدم المهمة الأولى داخل كل سجل مشاركة محتفظ به، وليس المهمة اللاحقة التي حذفت الكتاب المختار.[1]
يعرض المؤلفون بالفعل الاستجابات للترتيب والسعر. وتدرس أبحاثهم الأوسع كيف تساعد النصوص والصور في تقدير الاستبدال بين المنتجات. سؤالنا أضيق: هل يؤدي استبدال حد واحد للموضع إلى تحسين التنبؤ لمشاركين لم تُستخدم اختياراتهم في تدريب النموذجين؟
يترك اتباع قواعد الأهلية الأصلية 9,265 سجل مشاركة بمعرّفات Prolific مختلفة عددها 9,264. يظهر معرّف واحد (1) مرتين. نبقي سجلي المشاركة معا، ونعطي ذلك المشارك الوزن الإجمالي نفسه لكل مشارك آخر. سجل المشاركة لا يمثل تلقائيا شخصا منفصلا، والمهمة الأولى ليست بالضرورة أول تعرض لذلك الشخص للتجربة.[2][3]
تمتد تواريخ المصدر المحتفظ بها من 11 يونيو إلى 26 يونيو 2024. وتصف المخطوطة الفترة 14–27 يونيو، لذلك نفصح عن الفرق ولا نطبق استبعادا بحسب التاريخ. لم تثبت المواد المراجعة أهلية البلد والعمر؛ وليست هذه تقديرات للمتسوقين الأمريكيين أو لأي مجتمع وطني آخر.[1][2]
يبقى المشارك ضمن المجموعة نفسها طوال المقارنة
سجلات المشاركة المختارة للمهمة الأولى بعد تطبيق قواعد الأهلية الأصلية للمؤلفين؛ تواريخ سجلات المصدر المحتفظ بها من 11–26 يونيو 2024.
| المجموعة | المشاركون (بحسب معرّف المنصة) | سجلات المشاركة المحتفظ بها |
|---|---|---|
| جميع المحتفظ بهم | 9,264 | 9,265 |
| التدريب | 6,176 | 6,176 |
| محجوزون للتقييم | 3,088 | 3,089 |
أي من نموذجي الموضع تنبأ بصورة أفضل باختيارات المجموعة المحجوزة للتقييم؟
تنبأ نموذج الموضع المرن باختيارات المجموعة المحجوزة للتقييم بصورة أفضل بحسب مقياس التقييم المحدد مسبقا. يراعي النموذجان الكتاب المعروض وسعره الظاهر. ولا يختلفان إلا في طريقة تمثيل الموضع.
يستخدم النموذج الأساسي معاملا واحدا (1) لكل خطوة إلى أسفل القائمة. ويستخدم النموذج المرن تعديلات منفصلة للمواضع من 2 إلى 10 نسبة إلى الموضع الأول. يمنحه ذلك حرية أكبر، لكنه يزيد أيضا المعاملات المطلوب تقديرها. ولا تحسم ملاءمة أفضل لبيانات تدريبه وحدها المقارنة.
لذلك دربنا النموذجين باستخدام 6,176 مشاركا، وقيّمناهما على المشاركين الآخرين البالغ عددهم 3,088. بقي كل سجل مشاركة للشخص نفسه في جانب واحد من هذا التقسيم. تحتوي مجموعة الاختبار على 3,089 سجل مشاركة لأنها تضم المشارك المتكرر.
لمقارنة التنبؤات، استخدمنا درجة سالب اللوغاريتم. يتلقى النموذج عقوبة أصغر عندما يمنح احتمالا أكبر للاختيار الذي يتخذه الشخص فعلا. ويتلقى عقوبة أكبر عندما يمنح ذلك الاختيار احتمالا ضئيلا جدا. متوسط درجة سالب اللوغاريتم الأقل أفضل.
بلغ المتوسط في المجموعة المحجوزة للتقييم 2.2260 للنموذج الأساسي و2.2154 للنموذج المرن، بوحدات اللوغاريتم الطبيعي المسماة أيضا nats. هذه درجات تنبؤ، وليست نسبا مئوية للإجابات الصحيحة. تُعرض درجات التدريب والاختبار معا كي لا تعتمد المقارنة على المهمة الأسهل المتمثلة في وصف بيانات سبق أن رآها النموذج.
نموذجان (2) جرى تقييمهما على المشاركين أنفسهم
اختيارات مختارة للمهمة الأولى ذات الكتب العشرة (10) عام 2024. التدريب: 6,176 مشاركا وسجل مشاركة. الاختبار: 3,088 مشاركا و3,089 سجل مشاركة.
| نموذج الموضع | درجة التدريب (nats) | درجة المجموعة المحجوزة للتقييم (nats) |
|---|---|---|
| حد خطي واحد (1) للموضع | 2.2046 | 2.2260 |
| حدود منفصلة للمواضع | 2.1899 | 2.2154 |
بلغ التحسن في المقارنة المزدوجة 0.0106 nats لكل مشارك، بفترة تقريبية بنسبة 95% من 0.0044 إلى 0.0168. ويفضل التحسن الموجب هنا النموذج المرن. النتيجة صغيرة على مقياس التقييم هذا، لكن الفترة تقع فوق 0.[4]
تعامل هذه الفترة النموذجين المدربين (2) بوصفهما ثابتين، وتفترض استقلال مجموعات المشاركين. ولا تشمل عدم اليقين الناتج عن تدريب النموذجين على عينة تدريب أخرى. تدعم النتيجة تحسنا تنبؤيا في هذه المهمة التاريخية المختارة؛ ولا تحول فرق الدرجات إلى زيادة في المبيعات.
يحسن النموذج المرن الدرجة اللوغاريتمية للمجموعة المحجوزة للتقييم
مقارنة مزدوجة بين 3,088 مشاركا اختباريا في المهمة التاريخية المختارة ذات الكتب العشرة (10).
| المقارنة | التحسن (nats) | فترة 95%: الحد الأدنى (nats) | فترة 95%: الحد الأعلى (nats) |
|---|---|---|---|
| الدرجة اللوغاريتمية للمرن ناقص الأساسي | 0.0106 | 0.0044 | 0.0168 |
أين أخفق النموذجان (2) في توقع الاختيارات المرصودة؟
توضح المقارنة الكاملة للمواضع لماذا ينبغي إرفاق الدرجة الإجمالية بالتفاصيل. لكل موضع، نقارن نسبة اختياره المرصودة بمتوسط الاحتمال الذي يمنحه كل نموذج. هذه متوسطات متساوية الوزن لكل مشارك في المجموعة المحجوزة للتقييم، وليست معدلات نقر.
في الموضع 1، بلغت النسبة المرصودة 17.16%. تنبأ النموذج الأساسي بنسبة 14.64%، بينما تنبأ المرن بنسبة 17.73%. وفي الموضع 10، بلغت النسبة المرصودة 9.18%، مقابل تنبؤين قدرهما 6.37% و8.74%. كان النموذج المرن أقرب عند طرفي هذه القائمة المحددة.
الاختيارات المرصودة والمتنبأ بها في المواضع العشرة (10) كلها
المجموعة المحجوزة للتقييم: 3,088 مشاركا و3,089 سجل مشاركة للمهمة الأولى من التجربة المنشورة لعام 2024.
| الموضع | نسبة الاختيار المرصودة | متوسط احتمال النموذج الأساسي | متوسط احتمال النموذج المرن | سجلات المشاركة التي اختير فيها المنتج |
|---|---|---|---|---|
| الموضع 1 | 17.16% | 14.64% | 17.73% | 530 |
| الموضع 2 | 13.60% | 13.20% | 14.84% | 420 |
| الموضع 3 | 9.91% | 12.06% | 9.74% | 306 |
| الموضع 4 | 10.91% | 11.21% | 9.26% | 337 |
| الموضع 5 | 9.20% | 10.09% | 8.94% | 284 |
| الموضع 6 | 7.08% | 9.25% | 8.01% | 219 |
| الموضع 7 | 8.00% | 8.44% | 7.57% | 247 |
| الموضع 8 | 7.12% | 7.67% | 7.47% | 220 |
| الموضع 9 | 7.84% | 7.08% | 7.69% | 242 |
| الموضع 10 | 9.18% | 6.37% | 8.74% | 284 |
لم يكن النموذج المرن أقرب في كل موضع. ففي الموضع 4، بلغت النسبة المرصودة 10.91%. تنبأ الأساسي بنسبة 11.21%، بينما تنبأ المرن بنسبة 9.26%. حسنت المرونة الإضافية الدرجة الإجمالية للمجموعة المحجوزة للتقييم، مع إبقاء تباين أكبر في ذلك الموضع.
يعرض الجدول التالي النسب المرصودة ناقص النسب المتنبأ بها. تعني الفجوة الموجبة أن النموذج تنبأ باختيار أقل مما رُصد في ذلك الموضع؛ وتعني السالبة أنه تنبأ باختيار أكثر. إبقاء المواضع العشرة (10) كلها ظاهرة يمنع أن يحل طرف يبدو جيدا محل المقارنة الكاملة.
فجوات النموذجين عن الاختيارات المرصودة
نسبة الاختيار المرصودة ناقص متوسط الاحتمال المتنبأ به لكل موضع من المواضع العشرة (10)، باستخدام المشاركين الاختباريين أنفسهم وعددهم 3,088.
| الموضع | المرصود ناقص الأساسي | المرصود ناقص المرن |
|---|---|---|
| الموضع 1 | 2.52 نقاط مئوية | -0.57 نقاط مئوية |
| الموضع 2 | 0.41 نقاط مئوية | -1.24 نقاط مئوية |
| الموضع 3 | -2.15 نقاط مئوية | 0.17 نقاط مئوية |
| الموضع 4 | -0.29 نقاط مئوية | 1.65 نقاط مئوية |
| الموضع 5 | -0.89 نقاط مئوية | 0.26 نقاط مئوية |
| الموضع 6 | -2.17 نقاط مئوية | -0.93 نقاط مئوية |
| الموضع 7 | -0.44 نقاط مئوية | 0.43 نقاط مئوية |
| الموضع 8 | -0.55 نقاط مئوية | -0.35 نقاط مئوية |
| الموضع 9 | 0.76 نقاط مئوية | 0.14 نقاط مئوية |
| الموضع 10 | 2.81 نقاط مئوية | 0.44 نقاط مئوية |
صفوف المواضع هذه وصفية، ولا تتضمن ادعاءات دلالة إحصائية منفصلة. لم تقس التجربة حركات العين أو الانتباه، ولا يحدد هذا التحليل سبب اختلاف موضع. كما أن نمطا منحنيا للنسب المرصودة لا يدحض الأساسي وحده: فحد الموضع فيه خطي في درجة التفضيل الكامنة في النموذج، وليس في نسب الاختيار.
يجيب طرح النسبة المرصودة الأخيرة من الأولى ببساطة عن سؤال مختلف. تلخص تلك النسب الاختيارات عبر المنتجات والأسعار. يراعي النموذجان المدربان هوية الكتاب والسعر قبل توزيع الاحتمالات على الخيارات العشرة (10). ولا يخبرك فرق الطرفين أو مقارنة النموذجين بما سيحدث إذا نقلت منتجا معينا في متجر يعمل فعليا.
نموذج لقياس موضع المنتج يمكنك استخدامه
قبل مقارنة العروض، اكتب موجزا قصيرا للقياس. النموذج التالي متاح دون تسجيل وتوضيحي. وهو يطبق درس الدراسة بشأن فحص الافتراضات؛ ولا يعد بملاءمة النموذج الإحصائي نفسه لواجهة متجرك.
القرار: «نحتاج إلى تحديد [مقارنة المنتجات أو تغيير طريقة العرض] من أجل [الصفحة أو الحملة] خلال [الفترة]». حدد القرار قبل اختيار مقياس ملائم للنتيجة التي ترغب فيها.
النتيجة: «سنقيس [الاختيار أو النقر أو الإضافة إلى السلة أو الشراء]». اختر النتيجة التي تدعمها سجلاتك فعلا. واحتفظ إلى جانبها بالبدائل المعروضة وترتيبها وأسعارها الظاهرة. يجب إبقاء نتيجة الاختيار الإلزامي منفصلة عن نتيجة الشراء.
الوحدة: «وحدتنا هي [المشارك أو وحدة أخرى محددة بوضوح]. وسنتعامل مع الزيارات أو سجلات المشاركة المتكررة وفق [قاعدة]». أبق ملاحظات الشخص نفسه معا عند تقييم التنبؤ لأشخاص جدد. ولا تعتبر معرّف جلسة مجهولة الهوية إثباتا لشخص فريد.
المقارنة: «سيستخدم النموذجان المنتجات ومعلومات الأسعار والملاحظات المؤهلة نفسها. وسيختلفان في [افتراض الموضع]». حدد البديل البسيط وكذلك البديل الأكثر مرونة.
التقييم: «سنحجز [مجموعة محددة] قبل التدريب، ونقارن [مقياس تقييم مسمى]. وسنعرض جميع المواضع». حدد طريقة عرض نتيجة غير محسومة أو أسوأ قبل رؤيتها.
الاستخدام: «ستفيد هذه النتيجة [قرار القياس]. وما زلنا بحاجة إلى أدلة عن [نتيجة تجارية لم تُقس هنا] قبل [القرار التجاري]». تمنع هذه الجملة الأخيرة تحول تمرين تنبؤ بصمت إلى توقع للإيرادات.
أبق المشارك نفسه في جانب واحد من الاختبار
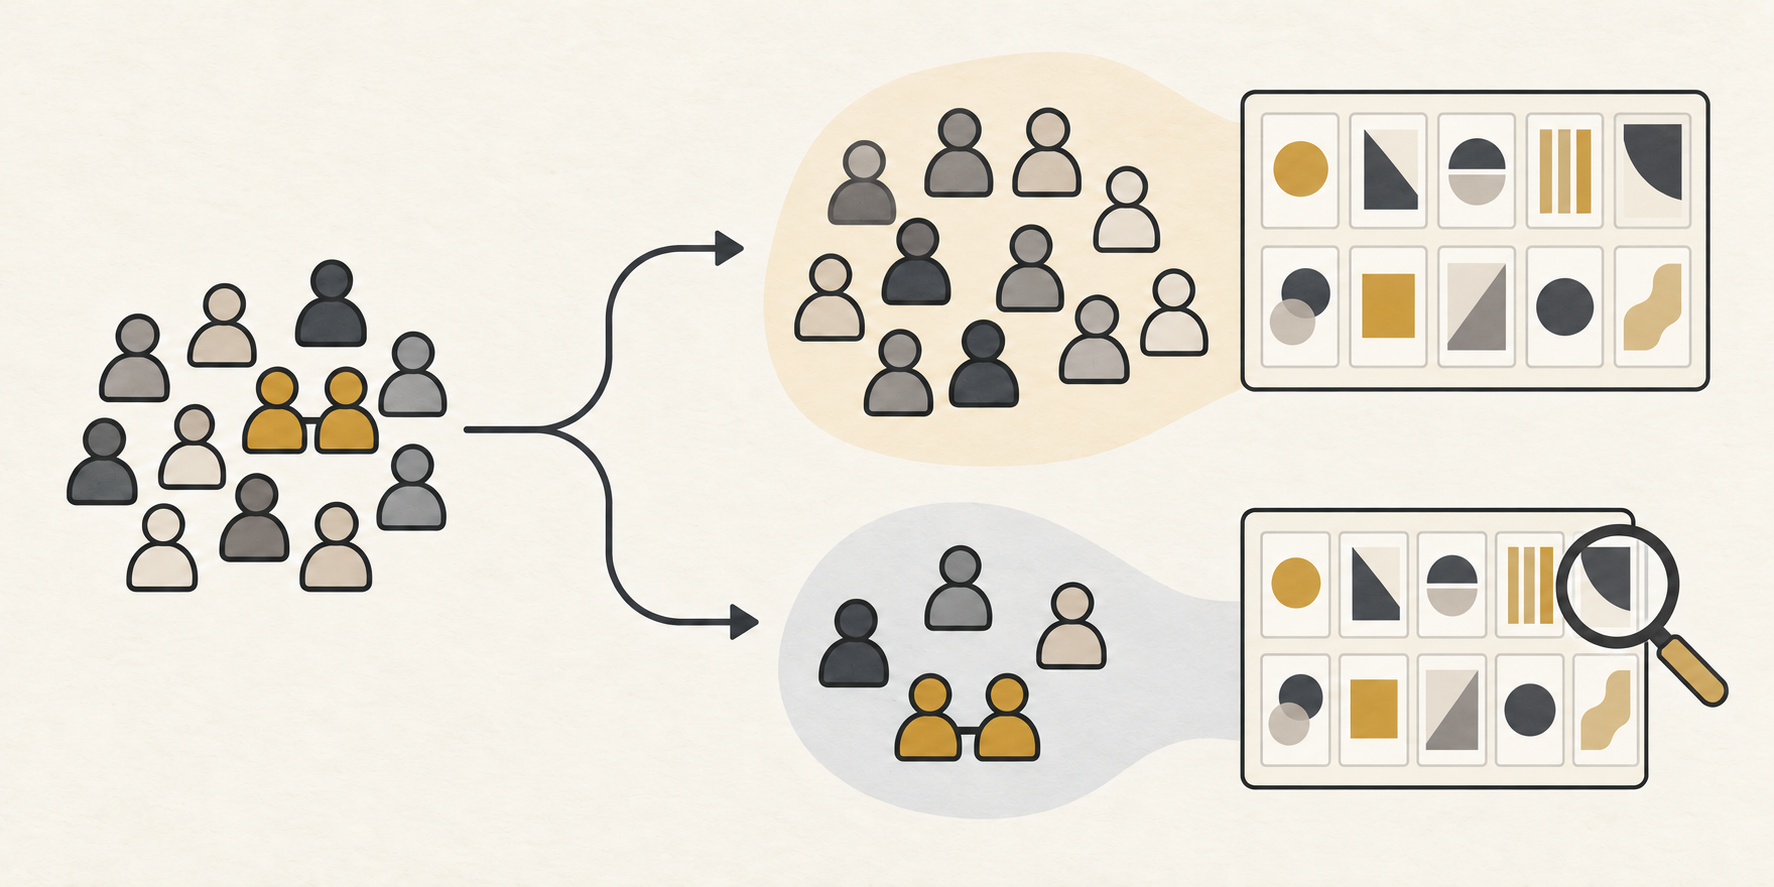
حدد المقارنة
سمّ المنتج والموضع والنتيجة ووحدة الملاحظة.
احجز مجموعة التقييم
أبق سجلات المشاركة لكل مشارك معا.
تحقق من النتيجة الكاملة
قارن التنبؤات واعرض كل موضع، بما فيه النتائج الأسوأ.
مثال تطبيقي: صانع محتوى يقارن عروضا رقمية
لنفترض أن صانع محتوى خياليا يبيع كتيب تمارين للكتابة وورشة عمل وحزمة. تظهر الحزمة في أعلى صفحة إطلاق، وتحصل على أكبر عدد من النقرات. ويفكر صانع المحتوى في إعادة كتابة أوصاف المنتجات الأخرى.
يغير موجز القياس السؤال المباشر. النتيجة المرصودة نقرة، وليست بيعا. يجب أن توضح السجلات المتاحة العروض التي ظهرت وترتيبها وأسعارها. وإذا احتلت الحزمة دائما الموضع الأول، فلا تستطيع تلك السجلات الفصل بوضوح بين الحزمة وموضعها.
قد يقول موجز صانع المحتوى المكتمل: «نريد معرفة ما إذا كانت طريقتنا لمراعاة الموضع تتنبأ بنقرات زوار جدد. سنقارن العروض ومعلومات الأسعار نفسها، ونبقي الملاحظات المتكررة معا، ونعرض المقارنة الكاملة للمواضع. لن ندعي شيئا عن المشتريات استنادا إلى سجلات النقر». هذا مثال خيالي لسؤال قياس، وليس نتيجة مقترحة.
خطوة تالية منطقية هي تخطيط مقارنة بتنوع كاف للتمييز بين المنتج والموضع، مع الاحتفاظ بتعريف النتيجة نفسه. يمكن لصانع المحتوى بعد ذلك مقارنة تعديل بسيط للموضع بآخر أكثر مرونة على مجموعة محجوزة. ستكون هذه دراسة جديدة لتلك الصفحة؛ ولا توفر تجربة الكتب معدل نقر متوقعا لها.
إذا تنبأ النهج المرن بالمجموعة المحجوزة بصورة أفضل، فلدى صانع المحتوى سبب لإعادة النظر في طريقة مراعاة التقرير للموضع. ولا يثبت ذلك بعد أن نقل الحزمة سيزيد الإيرادات. يتطلب القرار التجاري أدلة عن التغيير الفعلي في طريقة العرض والنتيجة التي تهم الشركة.
إذا بقيت المقارنة غير محسومة، فعلى صانع المحتوى التصريح بذلك. المرونة الإضافية ليست تلقائيا أداة عمل أفضل. المكسب العملي هو تسلسل أوضح: فهم ما تستطيع السجلات الفصل بينه، واختبار افتراض القياس، ثم تحديد ما إذا كانت هناك حاجة إلى تجربة أخرى.
كيف حسب Influence IQ المقارنة؟
استخدمنا إصدار الاستجابات المنقحة للمؤلفين وقواعد الاختيار الأصلية. تُستبعد سجلات المرحلة التمهيدية أو الاختبار الأولى البالغ عددها 553 بحسب موضعها الثابت في الملف. يحتوي الإطار المتبقي على 10,775 سجل مشاركة. وتترك مرشحات الفهم 9,344؛ ثم يترك مرشح الإكمال 9,265.[2]
لا تستبعد الموافقة وحالة الانتهاء وقاعدة الحد الأدنى للمدة البالغة 60 ثانية أي سجلات مشاركة إضافية في خطواتها المعنية. الإكمال والمدة مرشحان بعد التعرض، ولذلك تشكل المجموعة المحتفظ بها عينة مختارة.
تحدد معرّفات المشاركين في Prolific المجموعات. يخصص تقسيم حتمي قائم على دالة تجزئة ثلثي المجموعات للتدريب والبقية للاختبار، دون استخدام اختياراتهم. وداخل كل مجموعة، تتقاسم سجلات المشاركة المحتفظ بها للمهمة الأولى مساهمة ذلك المشارك بالتساوي. وينطبق الوزن نفسه على التدريب والتقييم وجداول المواضع.[3]
النموذجان من نوع لوجيت متعدد الحدود دون عقوبة إحصائية، مع 9 مؤشرات للكتب وحد خطي واحد (1) للسعر. يضيف الأساسي حدا خطيا واحدا (1) للموضع، ليصبح عدد المعاملات 11. ويضيف المرن 9 مؤشرات للمواضع، ليصبح العدد 19. يشكل الموضع 1 ومعرّف المنتج الأصغر رقميا الفئتين المرجعيتين. تحتوي جميع مجموعات الاختيار المؤهلة على المنتجات العشرة (10) نفسها، مع التحقق من توافق المعرّف المختار والسعر والموضع.
ندرب النموذجين على مجموعة التدريب، ونحتفظ بالمعاملات المقدرة، ثم نقيّم اختيارات الاختبار. تستخدم الفترة الانحراف المعياري لفروق الدرجات المزدوجة للمشاركين، ووحدات مشاركين عددها 3,088، ودرجات حرية عددها 3,087. إنها فترة Student-t تقريبية إلا عند تحقق افتراضاتها الدقيقة بشأن التوزيع الطبيعي للدرجات. وتبقى مقارنات المواضع العشر (10) كلها وصفية.[4]
أصدرت خوارزمية التحسين الرئيسية للنموذج الأساسي تحذيرا عدديا. ومع ذلك، استوفى كل شروط الدقة المحددة قبل التدريب، بما فيها المقارنة من نقطة بدء ثانية. احتفظنا بتلك الملاءمة الأصلية؛ وتضم مواد إعادة الإنتاج التشخيصات المفصلة.[5]
توفر التنزيلات النتائج المعروضة وشفرة التحليل الأصلية والمخرجات الرقمية المجمعة. وتستبعد صفوف استجابات المصدر ومعرّفات المشاركين وصور الكتب. احصل على بيانات المصدر بصورة منفصلة من إصدار المؤلفين. يتحمل Influence IQ مسؤولية إعادة التحليل هذه وتفسيرها.
يستخدم ملف CSV لغة هذه الصفحة. تحتوي الحزمة على شفرة الحساب الأصلية ووثائق المنهج المترجمة ونتائج مجمعة. لا تتضمن صفوف استجابات المصدر أو أصول الكتب؛ احصل على البيانات بصورة منفصلة من إصدار المؤلفين.
المصادر والملاحظات
- Compiani وMorozov وSeiler، Demand Estimation with Text and Image Data، إصدار المخطوطة 4، بتاريخ 17 فبراير 2026، القسم 3 والملحق C. يدرس المؤلفون بالفعل الاستجابات للترتيب والسعر. مقارنتنا على مشاركين محجوزين للتقييم إعادة تحليل أصلية أضيق نطاقا.
- إصدار DeepLogitReplication للمؤلفين عند المراجعة 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. نتبع الحد الأصلي القائم على موضع السجلات التمهيدية في ملف الاستجابات المنقحة، وقواعد الأهلية لدى المؤلفين. تواريخ المصدر المحتفظ بها هي 11–26 يونيو 2024، وتختلف عن وصف المخطوطة 14–27 يونيو؛ ولا تحدد التواريخ الإدراج.
- يميز Prolific معرّف المشارك عن معرّف الدراسة أو سجل المشاركة. نحافظ على معرّفات المشاركين الدقيقة لأغراض التجميع. لا تثبت هذه المعرّفات بصورة مستقلة أن كل معرّف يمثل شخصا مختلفا، أو أن سجل المشاركة المحتفظ به يمثل أول تعرض لذلك الشخص.
- تحسب مقارنة Influence IQ المحددة مسبقا متوسط احتمال الاختيار اللوغاريتمي في المرن ناقص الأساسي داخل كل مشارك اختباري، ثم بين المشاركين. فترة 95% هي المتوسط زائد أو ناقص القيمة الحرجة لتوزيع Student-t مضروبة في الانحراف المعياري للمشاركين ومقسومة على الجذر التربيعي للعدد 3,088. تفترض استقلال مجموعات المشاركين، وتشترط ثبات ملاءمات التدريب، وتستبعد عدم اليقين في ملاءمة التدريب؛ وتتطلب الدقة فروقا طبيعية متطابقة التوزيع بين المشاركين بتباين مشترك.
- أصدرت ملاءمة النموذج الأساسي التي بدأت من الصفر تحذير دقة. بلغ أقصى تدرج متوسط مطلق 3.12×10⁻⁹، ومقدار تناقص نيوتن 2.50×10⁻⁸، وأقصى فرق في الاحتمال اللوغاريتمي بين نقطتي بدء (2) قيمة 7.46×10⁻⁸، وهي أقل من الحدود المحددة مسبقا 10⁻⁸ و10⁻⁶ و10⁻⁷. واستوفى النموذجان أيضا شرطي الانحناء الموجب واتفاق دالة الهدف. واحتُفظ بمعاملات نقطة البدء الصفرية الرئيسية.
هذا المقال الإنجليزي هو النسخة المصدرية. تصف النسخ اللغوية التجربة التاريخية نفسها؛ وليست تقديرات للتسوق خاصة بكل بلد.